
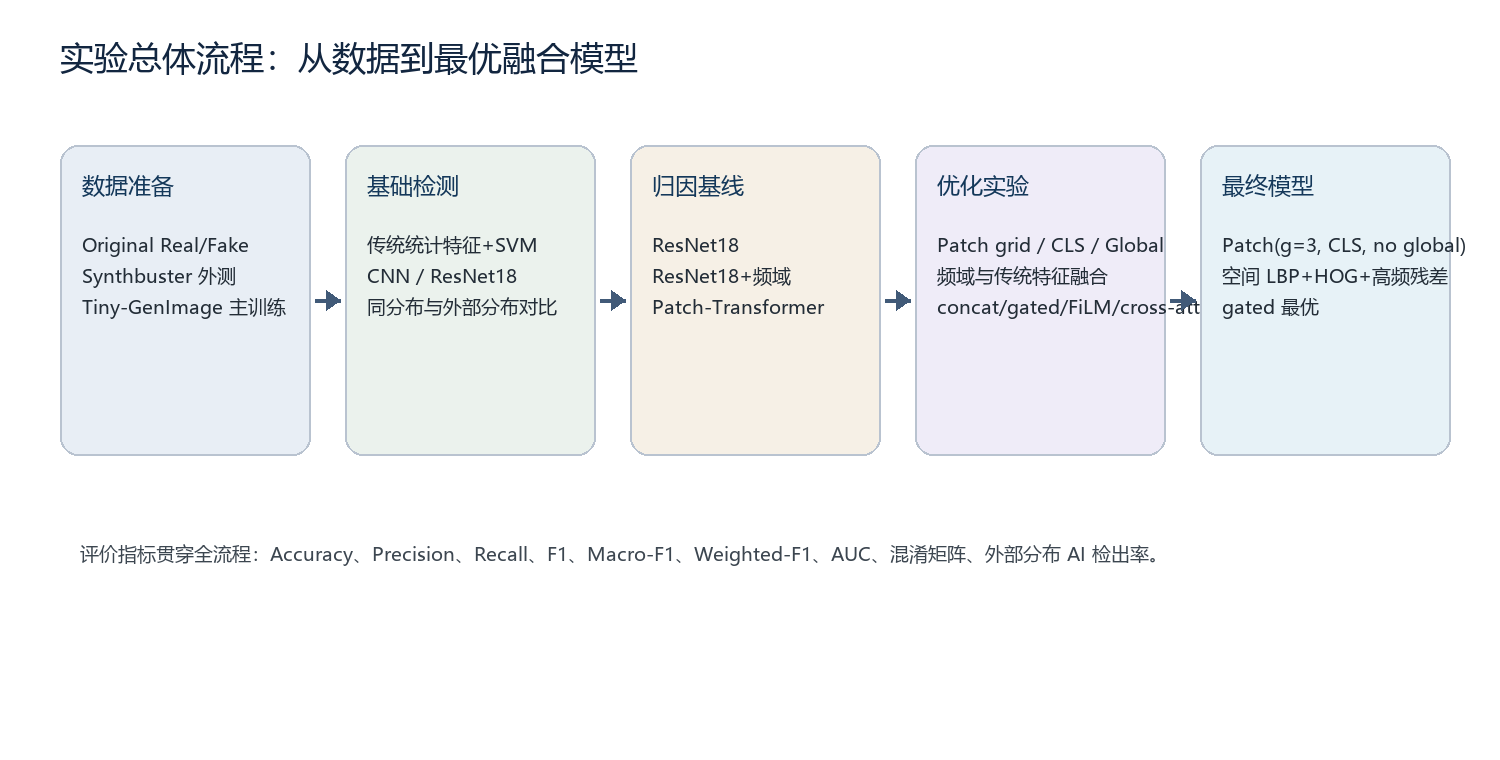
基于 ResNet18、频域分支、Patch-Transformer 与传统手工特征融合的 AIGC 图像检测实验。 本项目关注的不是"能不能测出 AI 图",而是跨生成器泛化与生成器溯源这两个更难的问题。
文中图表托管在 jsDelivr CDN(国内网络可直接显示),原图同时保存在仓库
docs/figures/目录。
| 结论 | 证据 |
|---|---|
| 同分布二分类几乎饱和,但外部分布严重失效 | Original 测试集 ResNet18 准确率 99.36%;Synthbuster 上 AI 检出率仅 0.83% |
| 全局特征压扁了局部伪影,Patch 结构更有效 | 9 类 Macro-F1:ResNet18 55.53% → Patch-Transformer 58.98% |
| 频域特征不是万能药,接在全局向量后几乎无效 | ResNet18+频域 55.54%(≈ 无提升);与 Patch 融合后升至 79.81% |
| 空间结构传统特征 > 全局统计型传统特征 | 全局统计 all 77.17% → 空间 LBP+HOG+高频 strict_all 77.42% |
| gated 融合优于 concat / FiLM / cross-attention | Patch+空间传统 gated 81.49%,cross-attn 80.51%,FiLM 78.95% |
最终最优配置:patch_grid=3、use_cls=True、use_global=False + 空间结构 LBP/HOG/高频残差 + gated 融合,
多分类 Acc 86.27%,Macro-F1 81.49%,AUC 97.88%。
同时评估两个层次:
- 多分类归因:在
Real+ 8 类生成器共 9 类上做生成器溯源 - 二分类检测:
Real为真、其余全部生成器为假
类别顺序固定为:
Real, ADM, BigGAN, GLIDE, Midjourney, SD14, SD15, VQDM, Wukong
Tiny-GenImage 验证集中 Real 类样本数远多于单个生成器类。只看 Accuracy,模型把困难的生成器错分为 Real 或相近生成器,仍能维持较高总体准确率。Macro-F1 对每个类等权,更能暴露 ADM、Midjourney、SD15、Wukong 等困难类的归因问题。
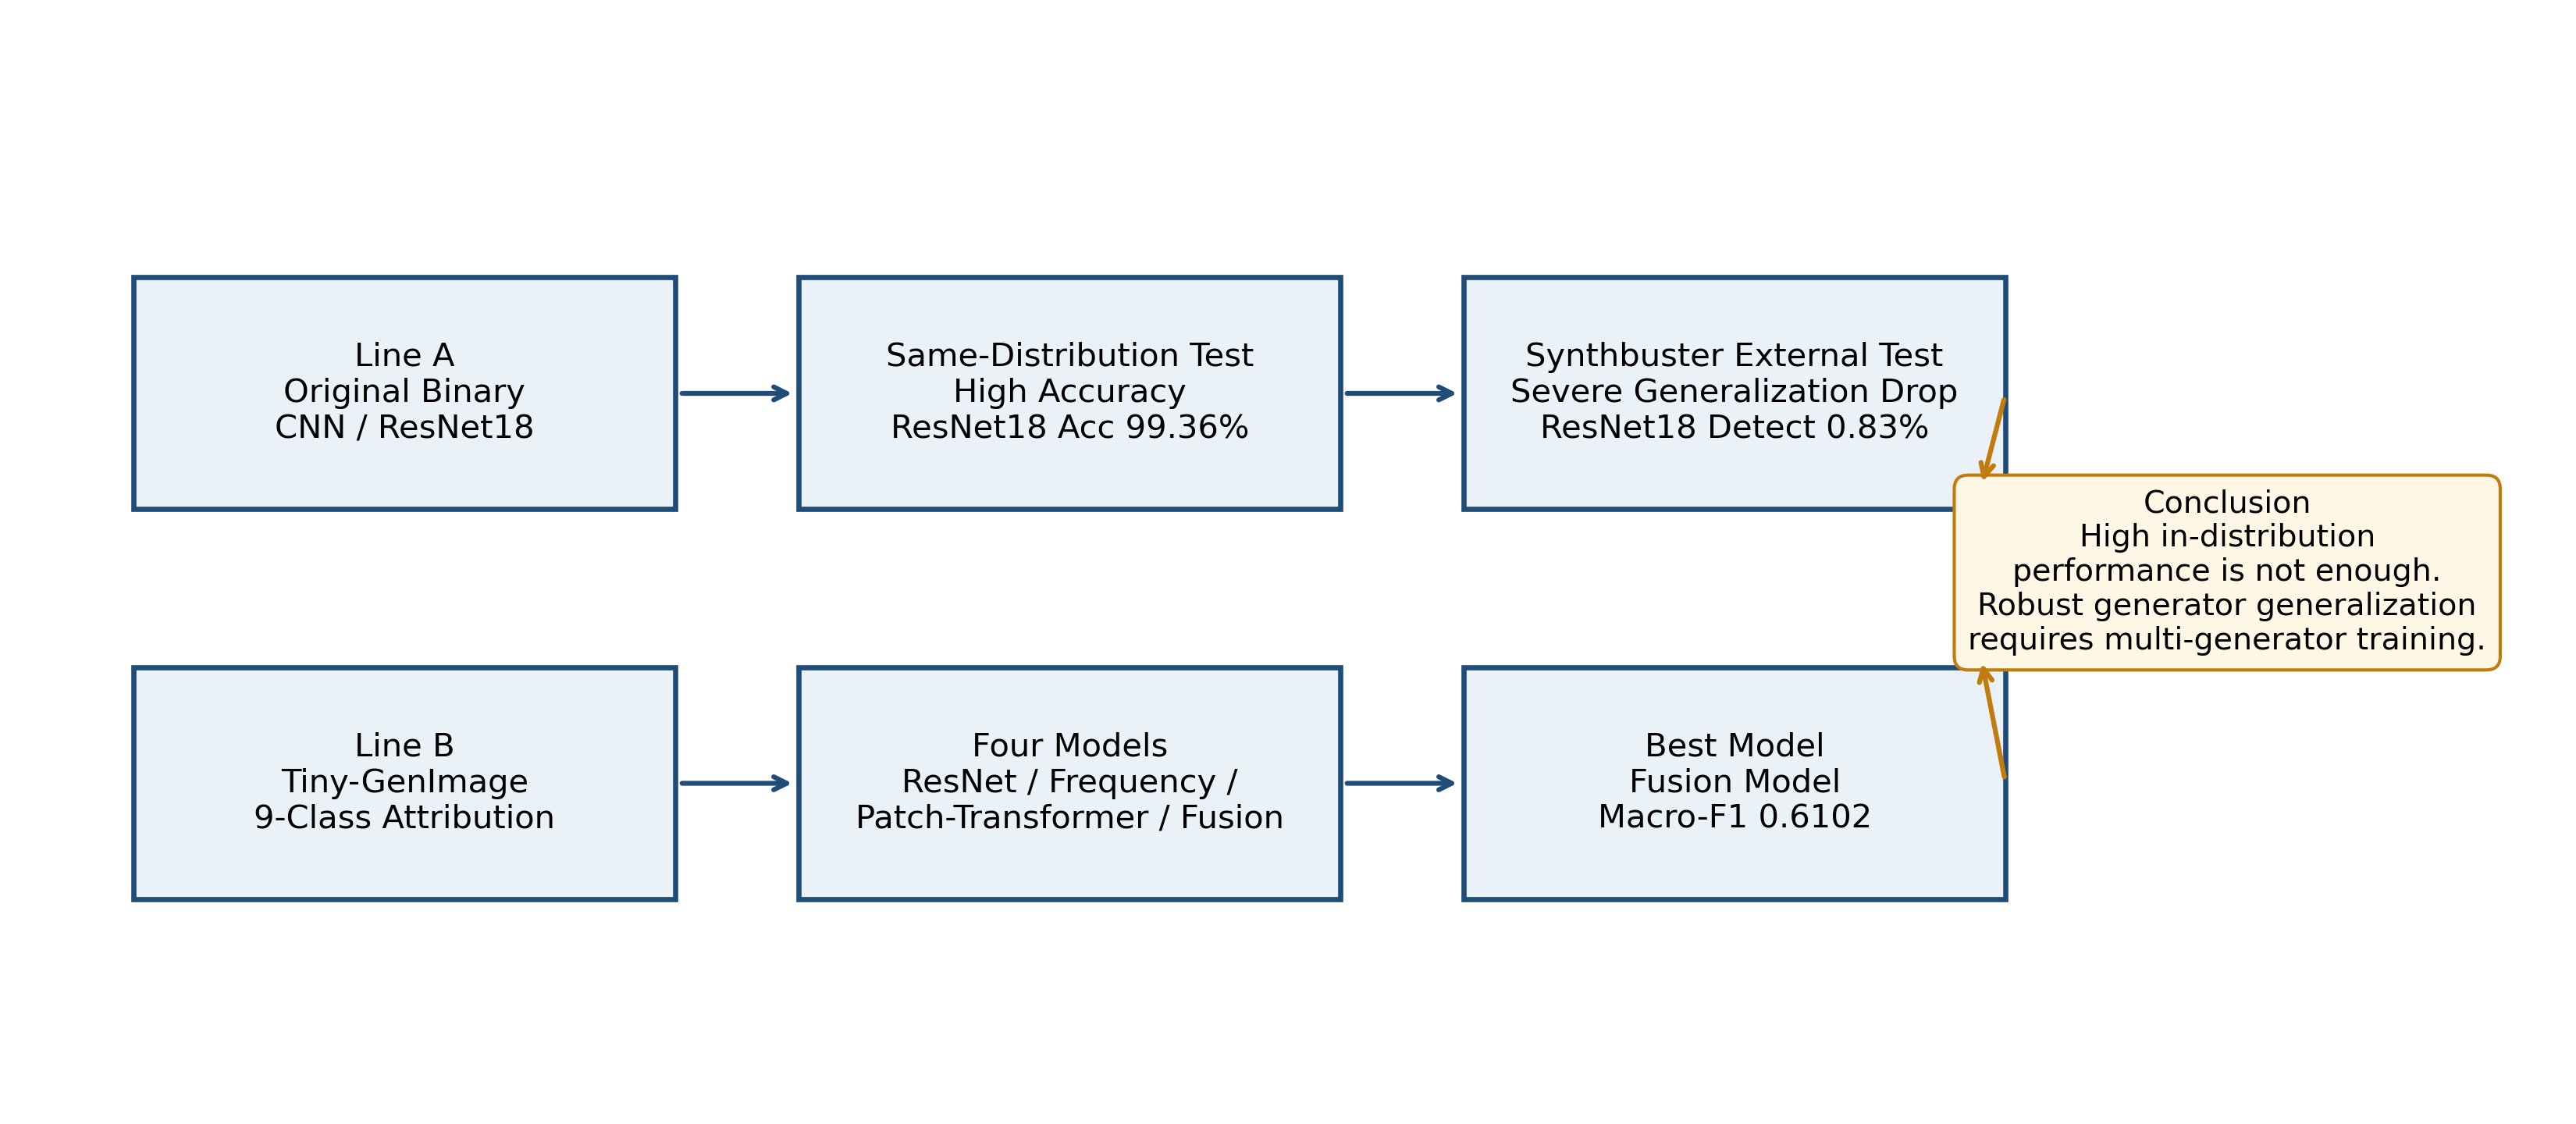
项目分两条线推进:
A 线(早期):Original Real/Fake 同分布 → Synthbuster 外部泛化测试 B 线(主线):Tiny-GenImage 9 类归因 → Patch 优化 → 频域/传统特征融合
| 数据集 | 用途 | 类别 | 规模与特点 |
|---|---|---|---|
| Original Real/Fake | 早期二分类验证 | Real / Fake | 同分布测试,CNN/ResNet 训练稳定 |
| Synthbuster | 外部泛化(OOD) | 9 类生成器 | 每类约 1000 张,共约 9000;缺真实类,规模小 |
| Tiny-GenImage | 主训练与验证 | 9 类 | 百万级,适合生成器溯源 |
Tiny-GenImage 以 parquet shard 存储。common.py 中的 prepare_image_cache 读取 train/validation parquet,
把 image.bytes 解码为 RGB 并写入 cache/images/split/class/,同时生成 manifest CSV
(字段:image_path、label、label_name、binary_label、split)。
数据增强:训练集 RandomResizedCrop(scale=0.75~1.0) + 水平翻转 + ColorJitter;验证集 Resize + CenterCrop。
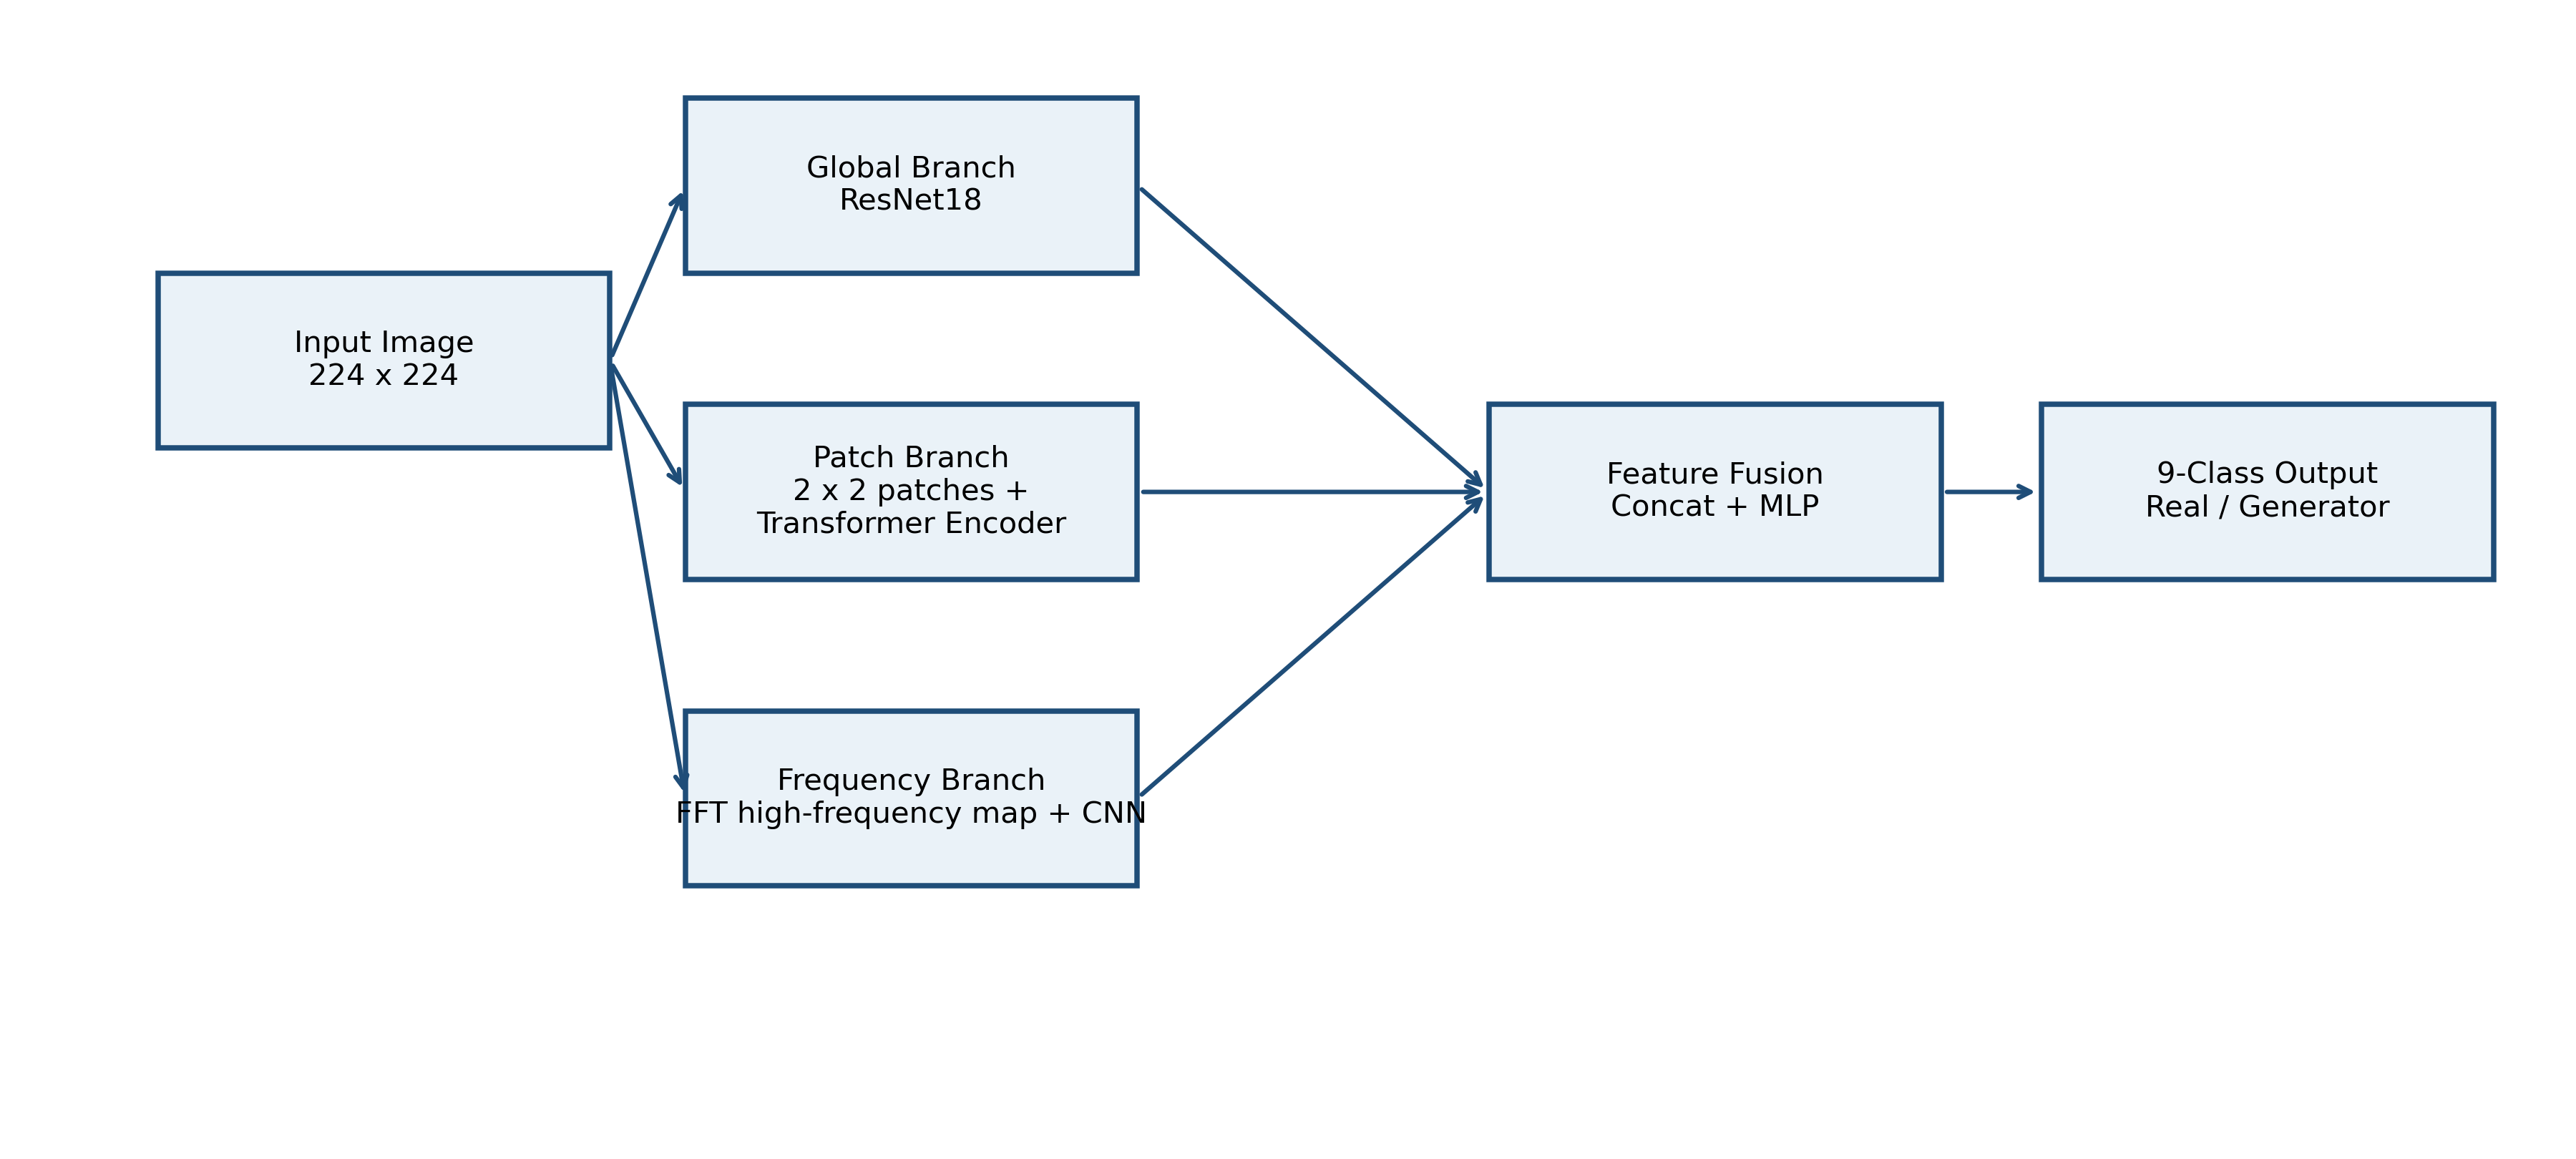
| 实验名 | 结构要点 |
|---|---|
resnet18_baseline |
ResNet18,替换 fc 层作为基线 |
resnet18_frequency |
ResNet18 + FFT 幅度谱分支(遮蔽中心 20% 低频后接小型 CNN) |
patch_transformer |
图像切 g×g 块,共享 ResNet18 编码为 token,Transformer 编码后 mean-pool |
fusion_model |
全局 ResNet18 + 切块 Transformer + 频域分支三路 concat |
patch_transformer_optimized |
切块改进:加 CLS token / 全局 token,可调 grid 与层数 |
resnet18_traditional_* |
ResNet18 + 手工特征,支持 concat / gated / film / hand_only |
train_resnet18_traditional_fusion.py 定义 5 组特征用于控制变量筛选:
| 组 | 内容 |
|---|---|
first20 |
灰度均值/方差、拉普拉斯方差、FFT 平均能量 + 16 bin 灰度直方图 |
color |
RGB 均值/标准差/偏度 + 12 bin HSV 直方图 |
texture |
16 bin LBP 直方图、Sobel 统计量、拉普拉斯绝对均值 |
frequency |
8 bin FFT 径向能量、低/中/高频能量、高频低频比 |
all |
以上四组全部拼接 |
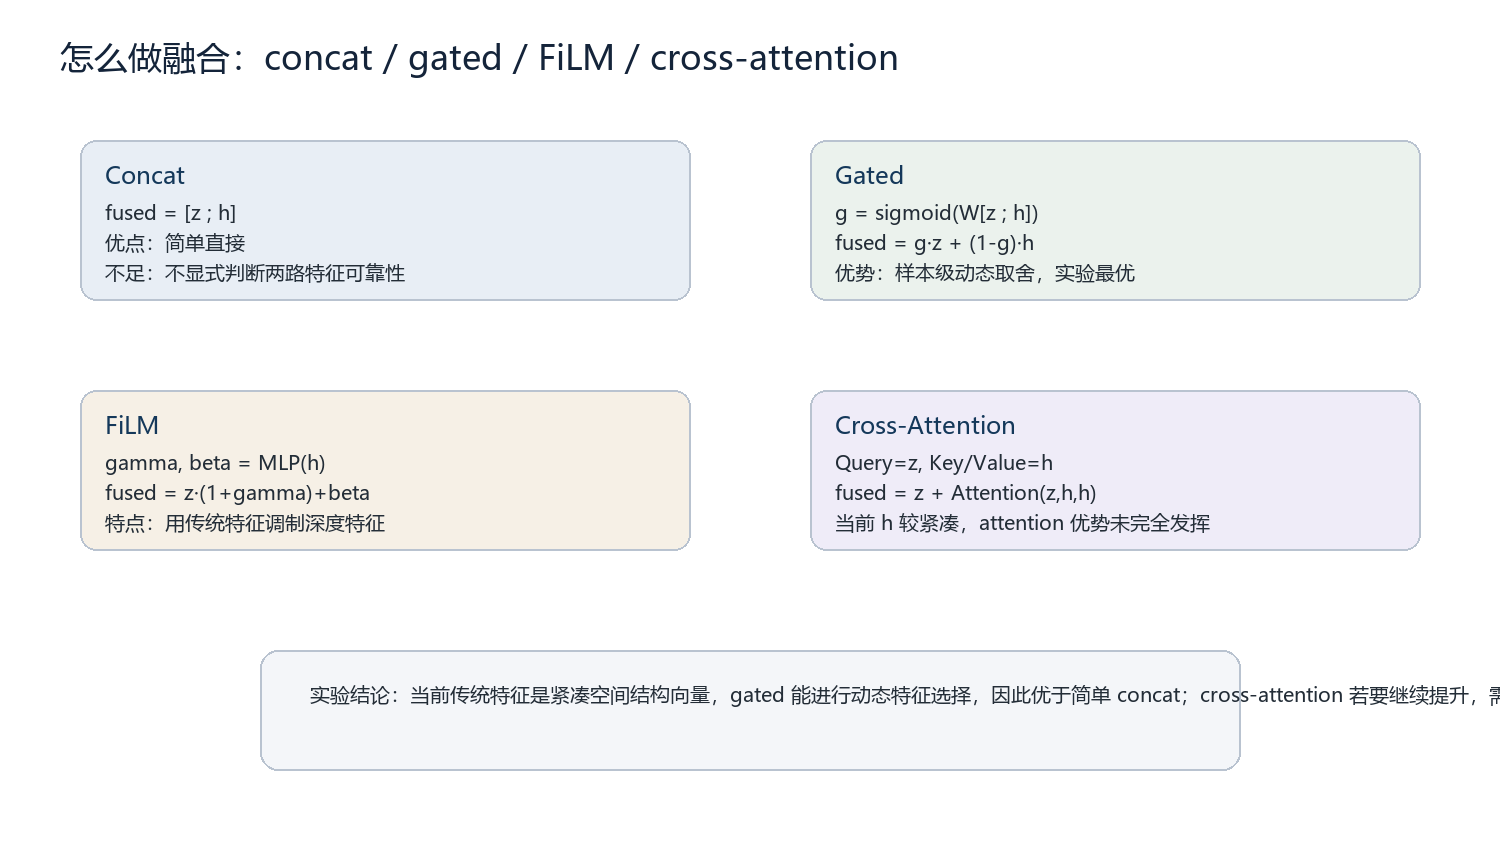
设深度特征 z、传统特征投影 h:
- Concat:
fused = [z; h] - Gated:
g = sigmoid(W[z; h]),fused = g⊙z + (1-g)⊙h - FiLM:
γ, β = MLP(h),fused = z⊙(1+γ) + β - Cross-Attention:
Query=z,Key/Value=h,fused = z + Attention(z, h, h)
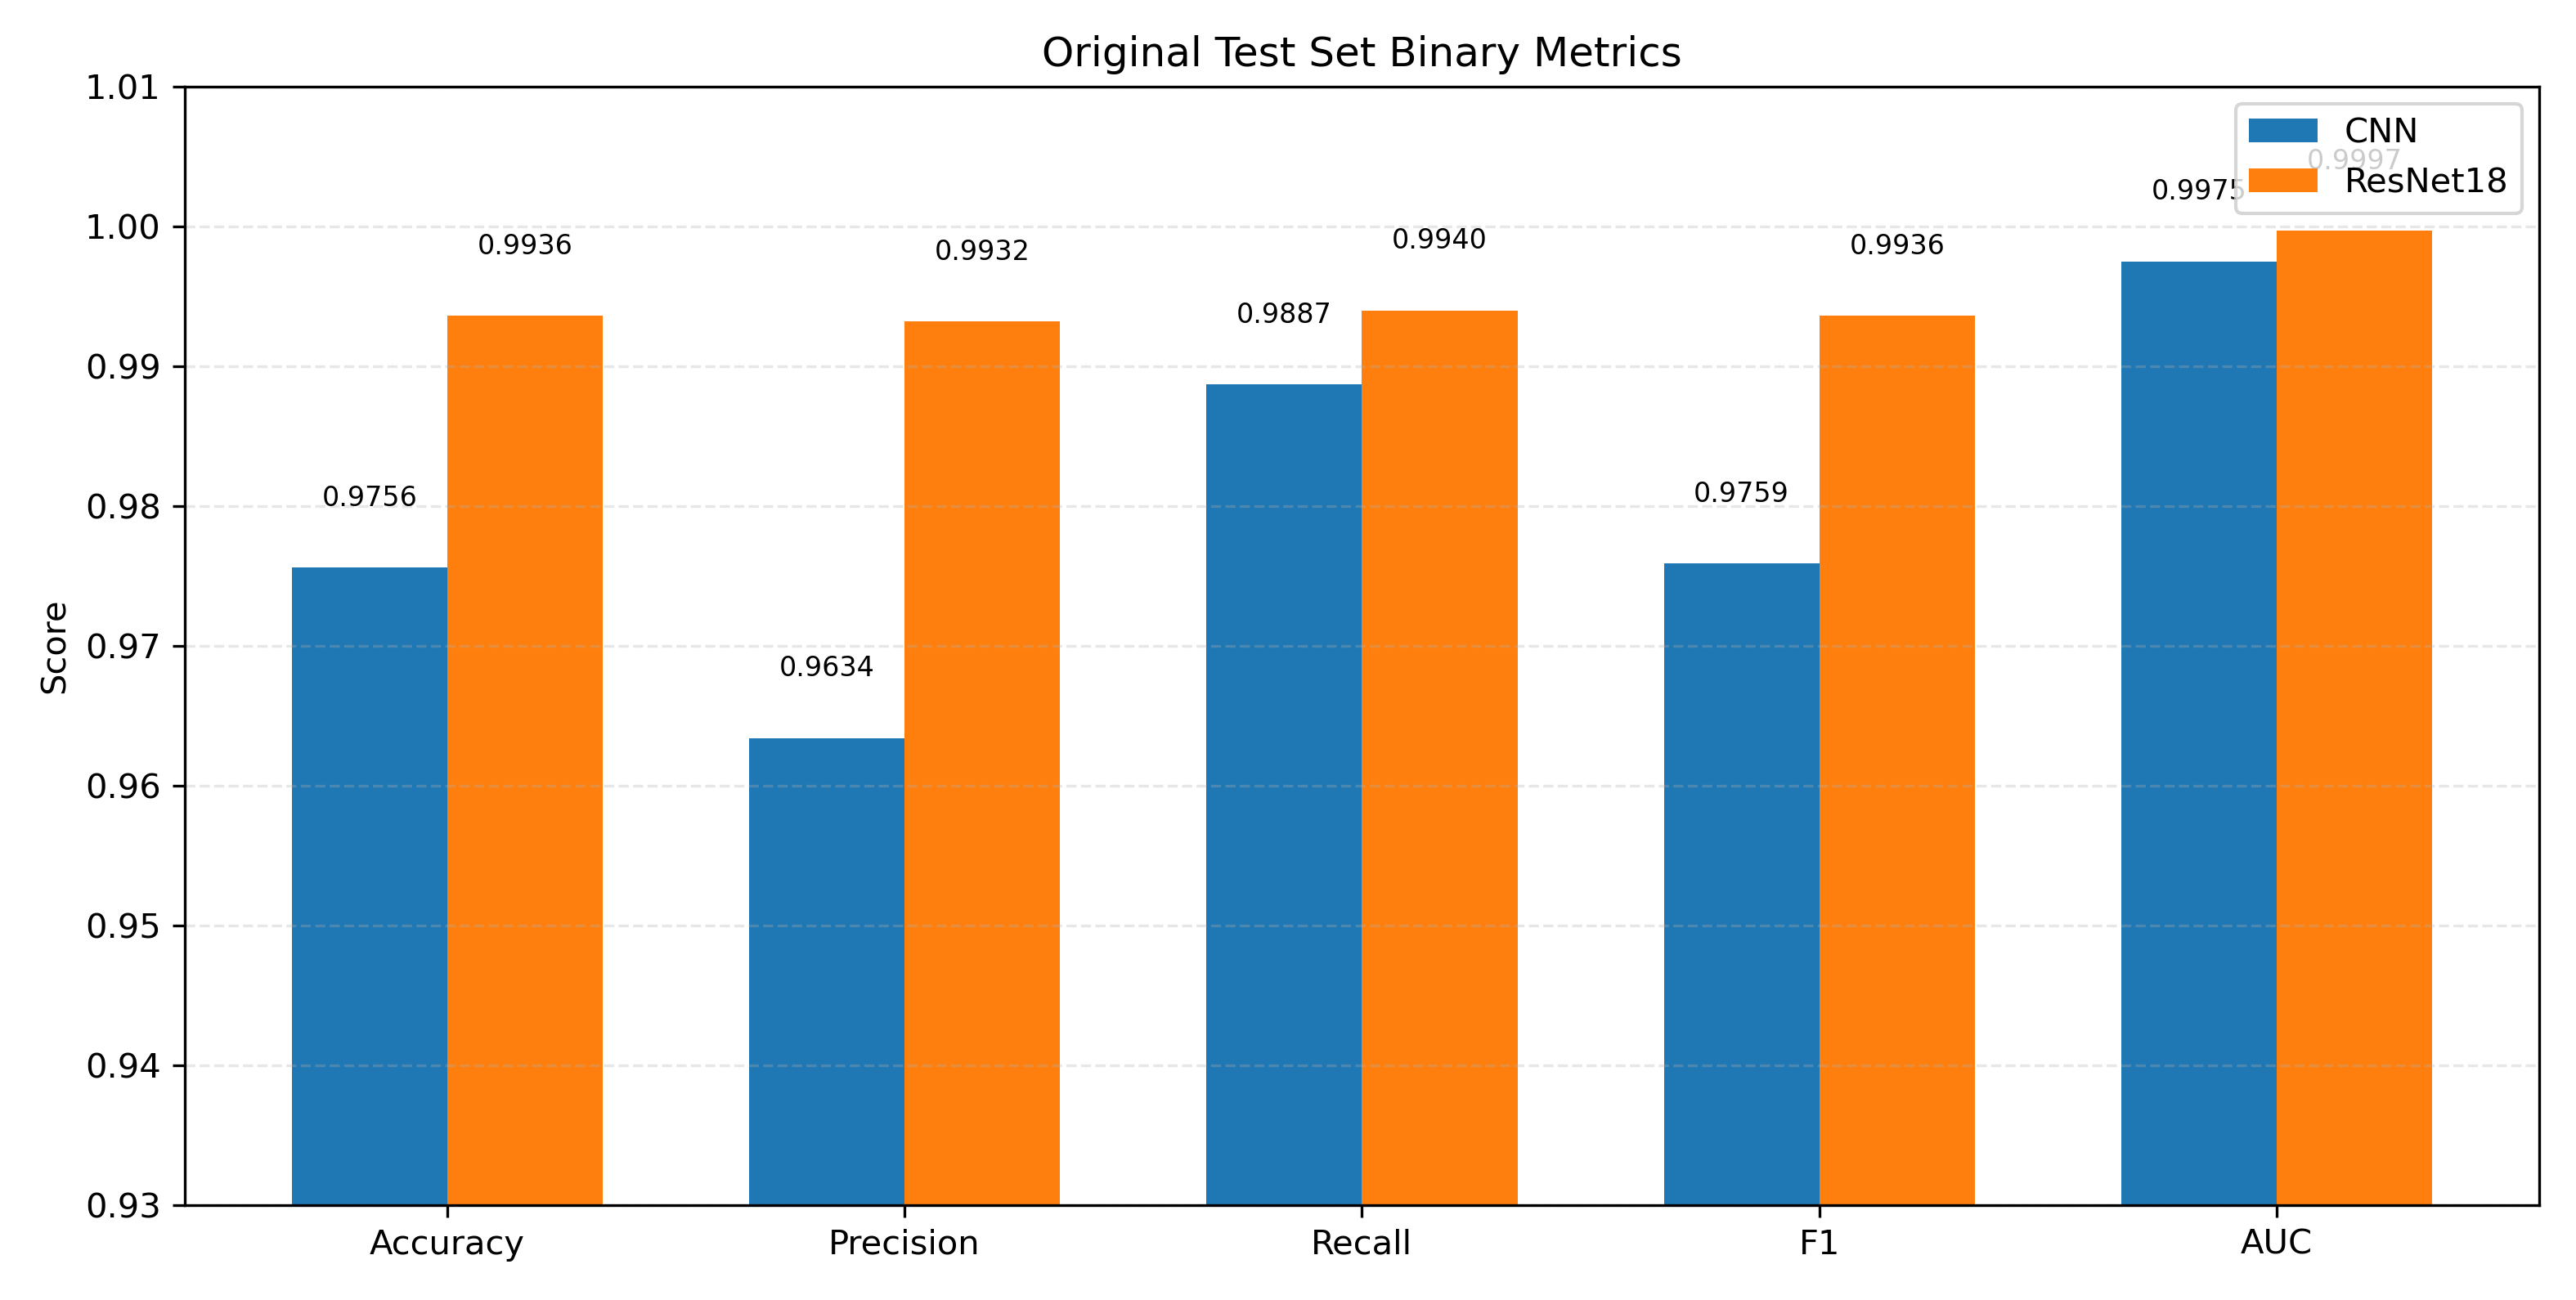
| 模型 | Accuracy | Precision | Recall | F1 | AUC |
|---|---|---|---|---|---|
| CNN | 97.56% | 96.34% | 98.87% | 97.59% | 99.75% |
| ResNet18 | 99.36% | 99.32% | 99.40% | 99.36% | 99.97% |
同分布上两者都接近满分,说明任务本身不难。但换到 Synthbuster 外部分布:
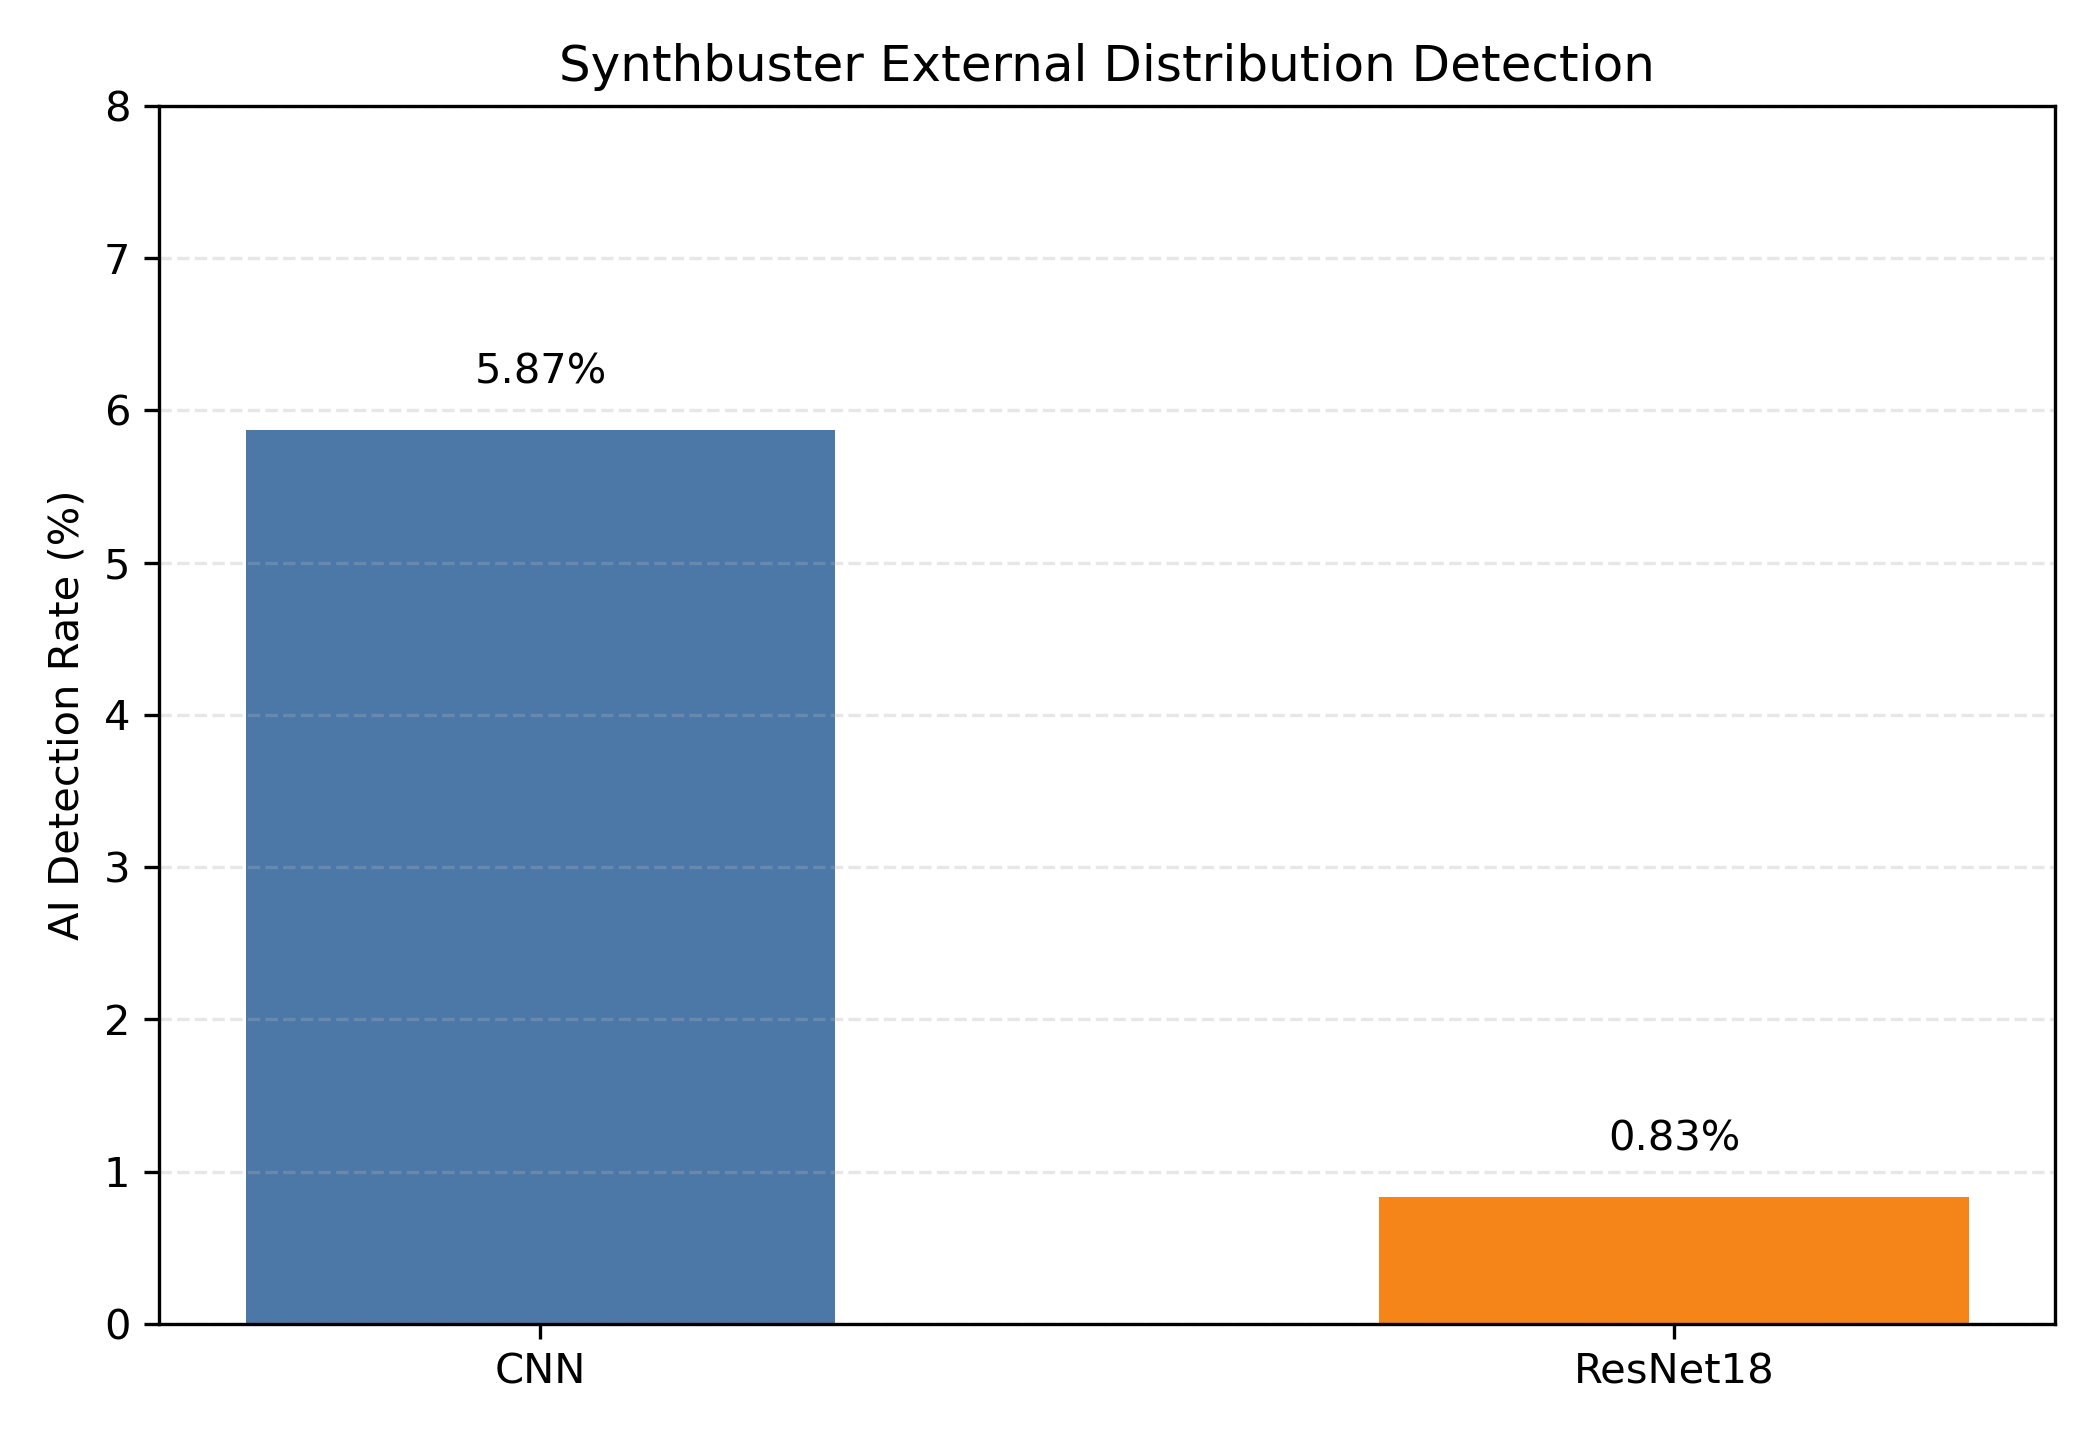
CNN AI 检出率 5.87%,ResNet18 0.83%。
| 生成器 | 样本数 | AI 检出率 | 平均 Fake 概率 |
|---|---|---|---|
| dalle2 | 1000 | 0.80% | 0.0156 |
| dalle3 | 1000 | 0.70% | 0.0123 |
| firefly | 1000 | 0.20% | 0.0038 |
| glide | 1000 | 1.40% | 0.0203 |
| midjourney-v5 | 1000 | 0.10% | 0.0037 |
| stable-diffusion-1-3 | 1000 | 1.60% | 0.0206 |
| stable-diffusion-1-4 | 1000 | 2.10% | 0.0224 |
| stable-diffusion-2 | 1000 | 0.30% | 0.0060 |
| stable-diffusion-xl | 1000 | 0.30% | 0.0068 |
| ALL | 9000 | 0.83% | 0.0124 |
模型学到的不是"AI 图像的通用伪影",而是与训练数据源、压缩格式、生成器版本强相关的偏差。
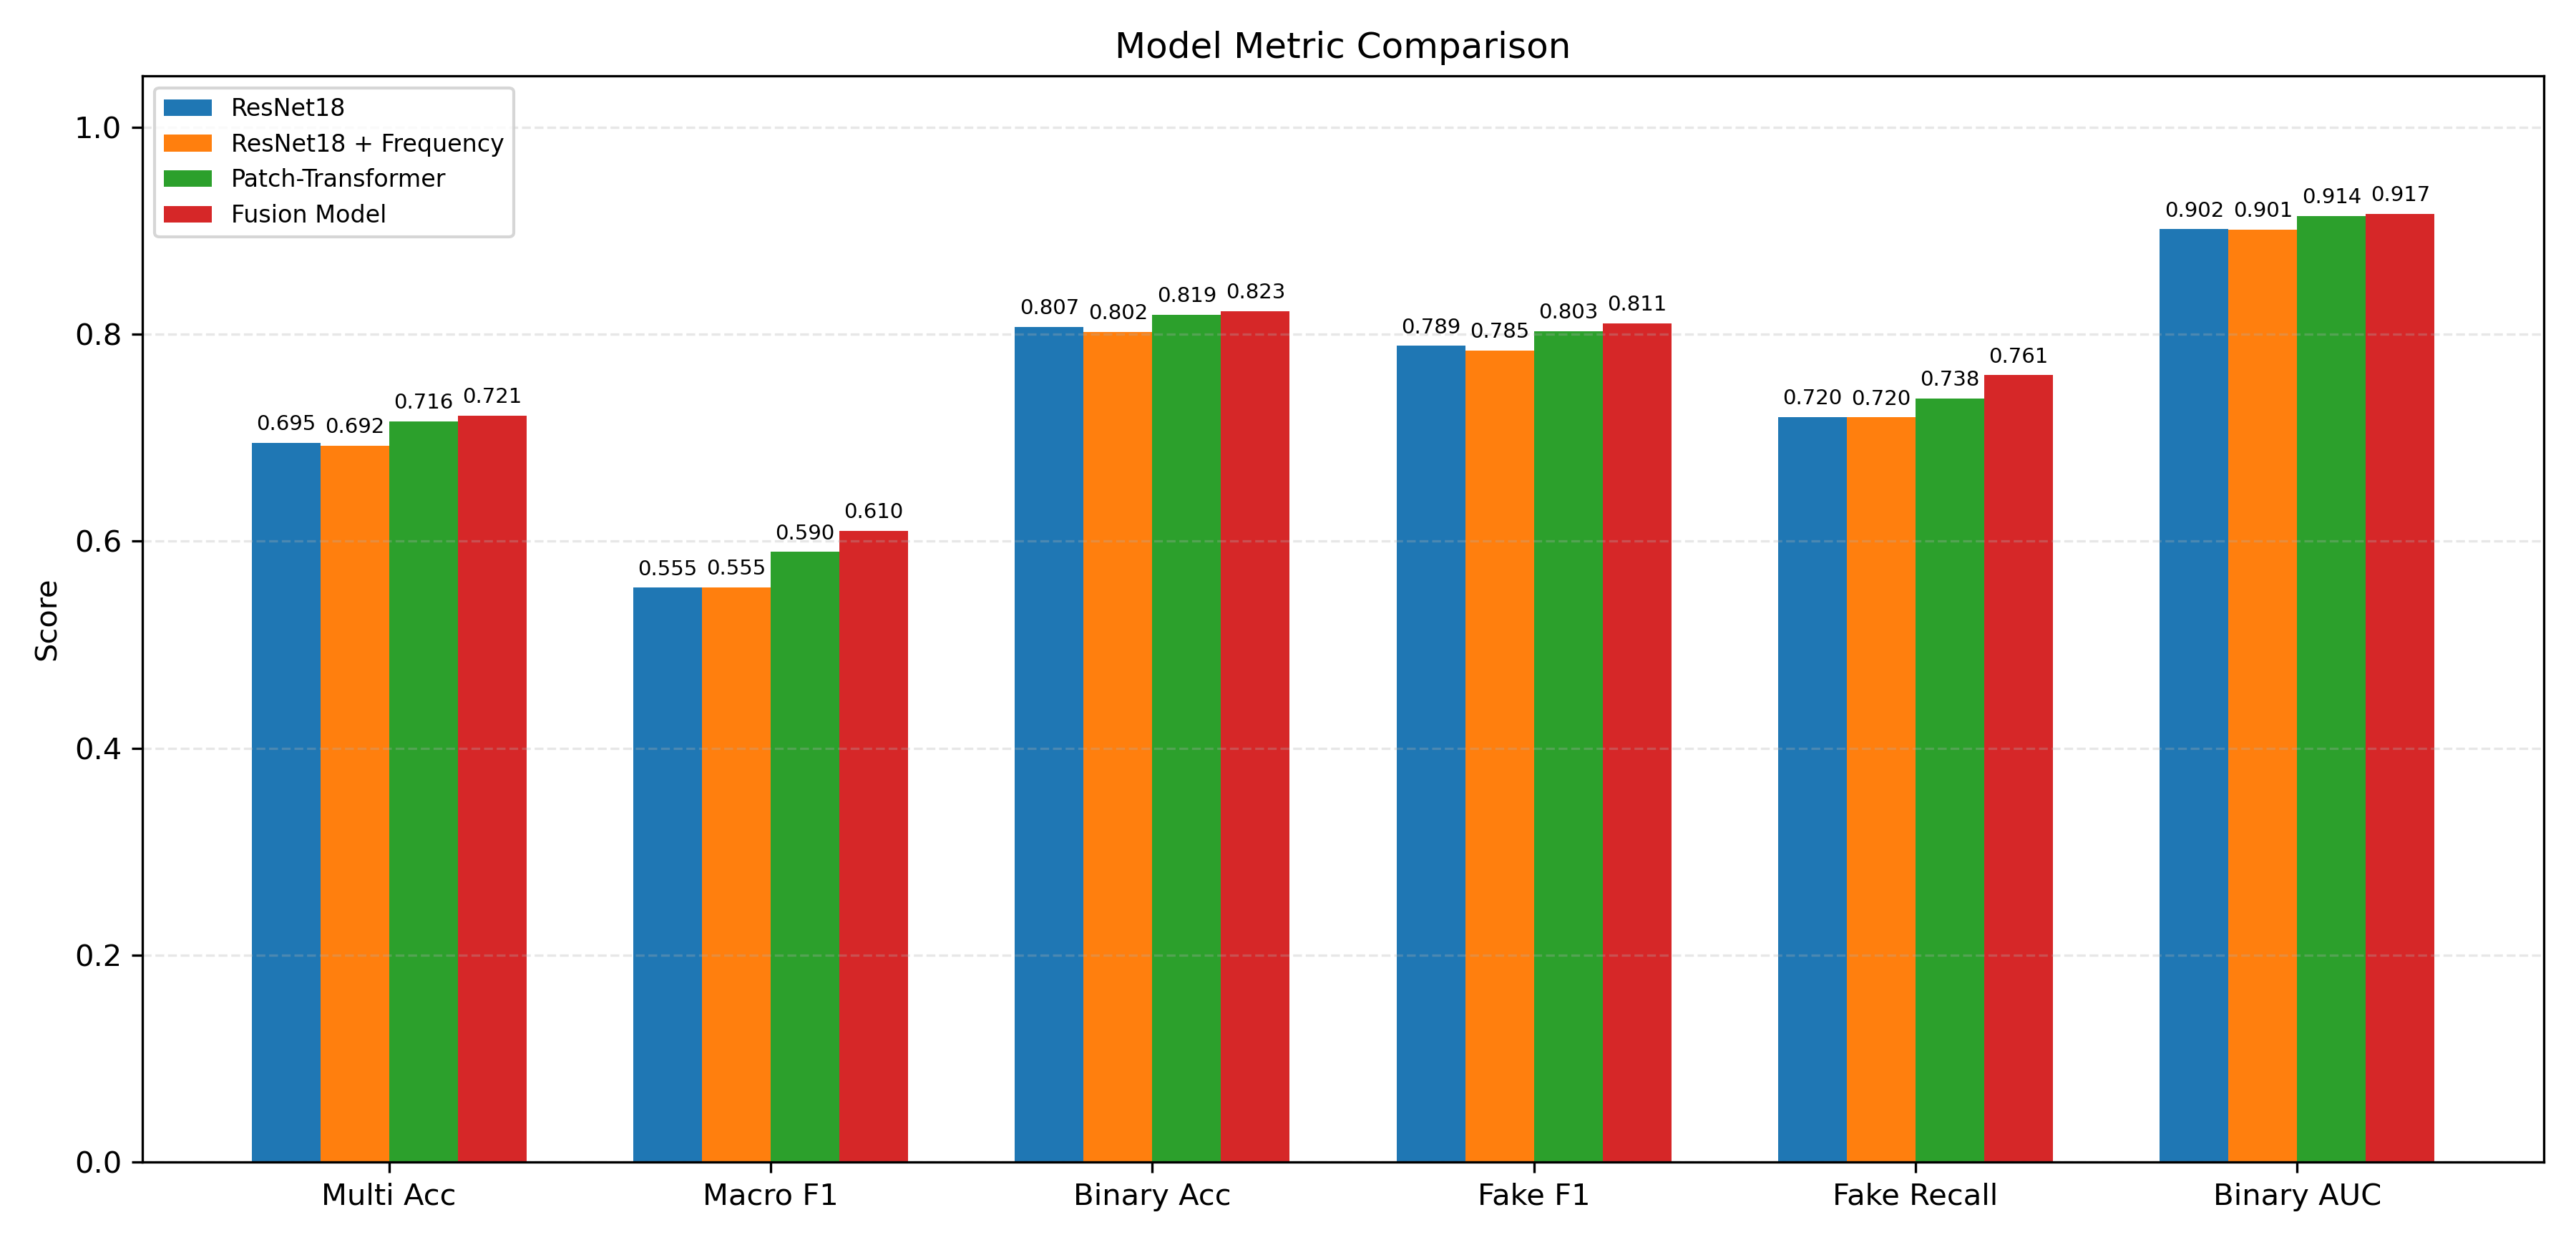
| 模型 | 多分类 Acc | Macro-F1 | 二分类 Acc | Fake-F1 | AUC |
|---|---|---|---|---|---|
| ResNet18 baseline | 69.53% | 55.53% | 80.74% | 78.90% | 90.17% |
| ResNet18 + 频域 | 69.24% | 55.54% | 80.24% | 78.46% | 90.14% |
| Patch-Transformer | 71.60% | 58.98% | 81.91% | 80.32% | 91.44% |
| Fusion Model | 72.14% | 61.02% | 82.26% | 81.08% | 91.68% |
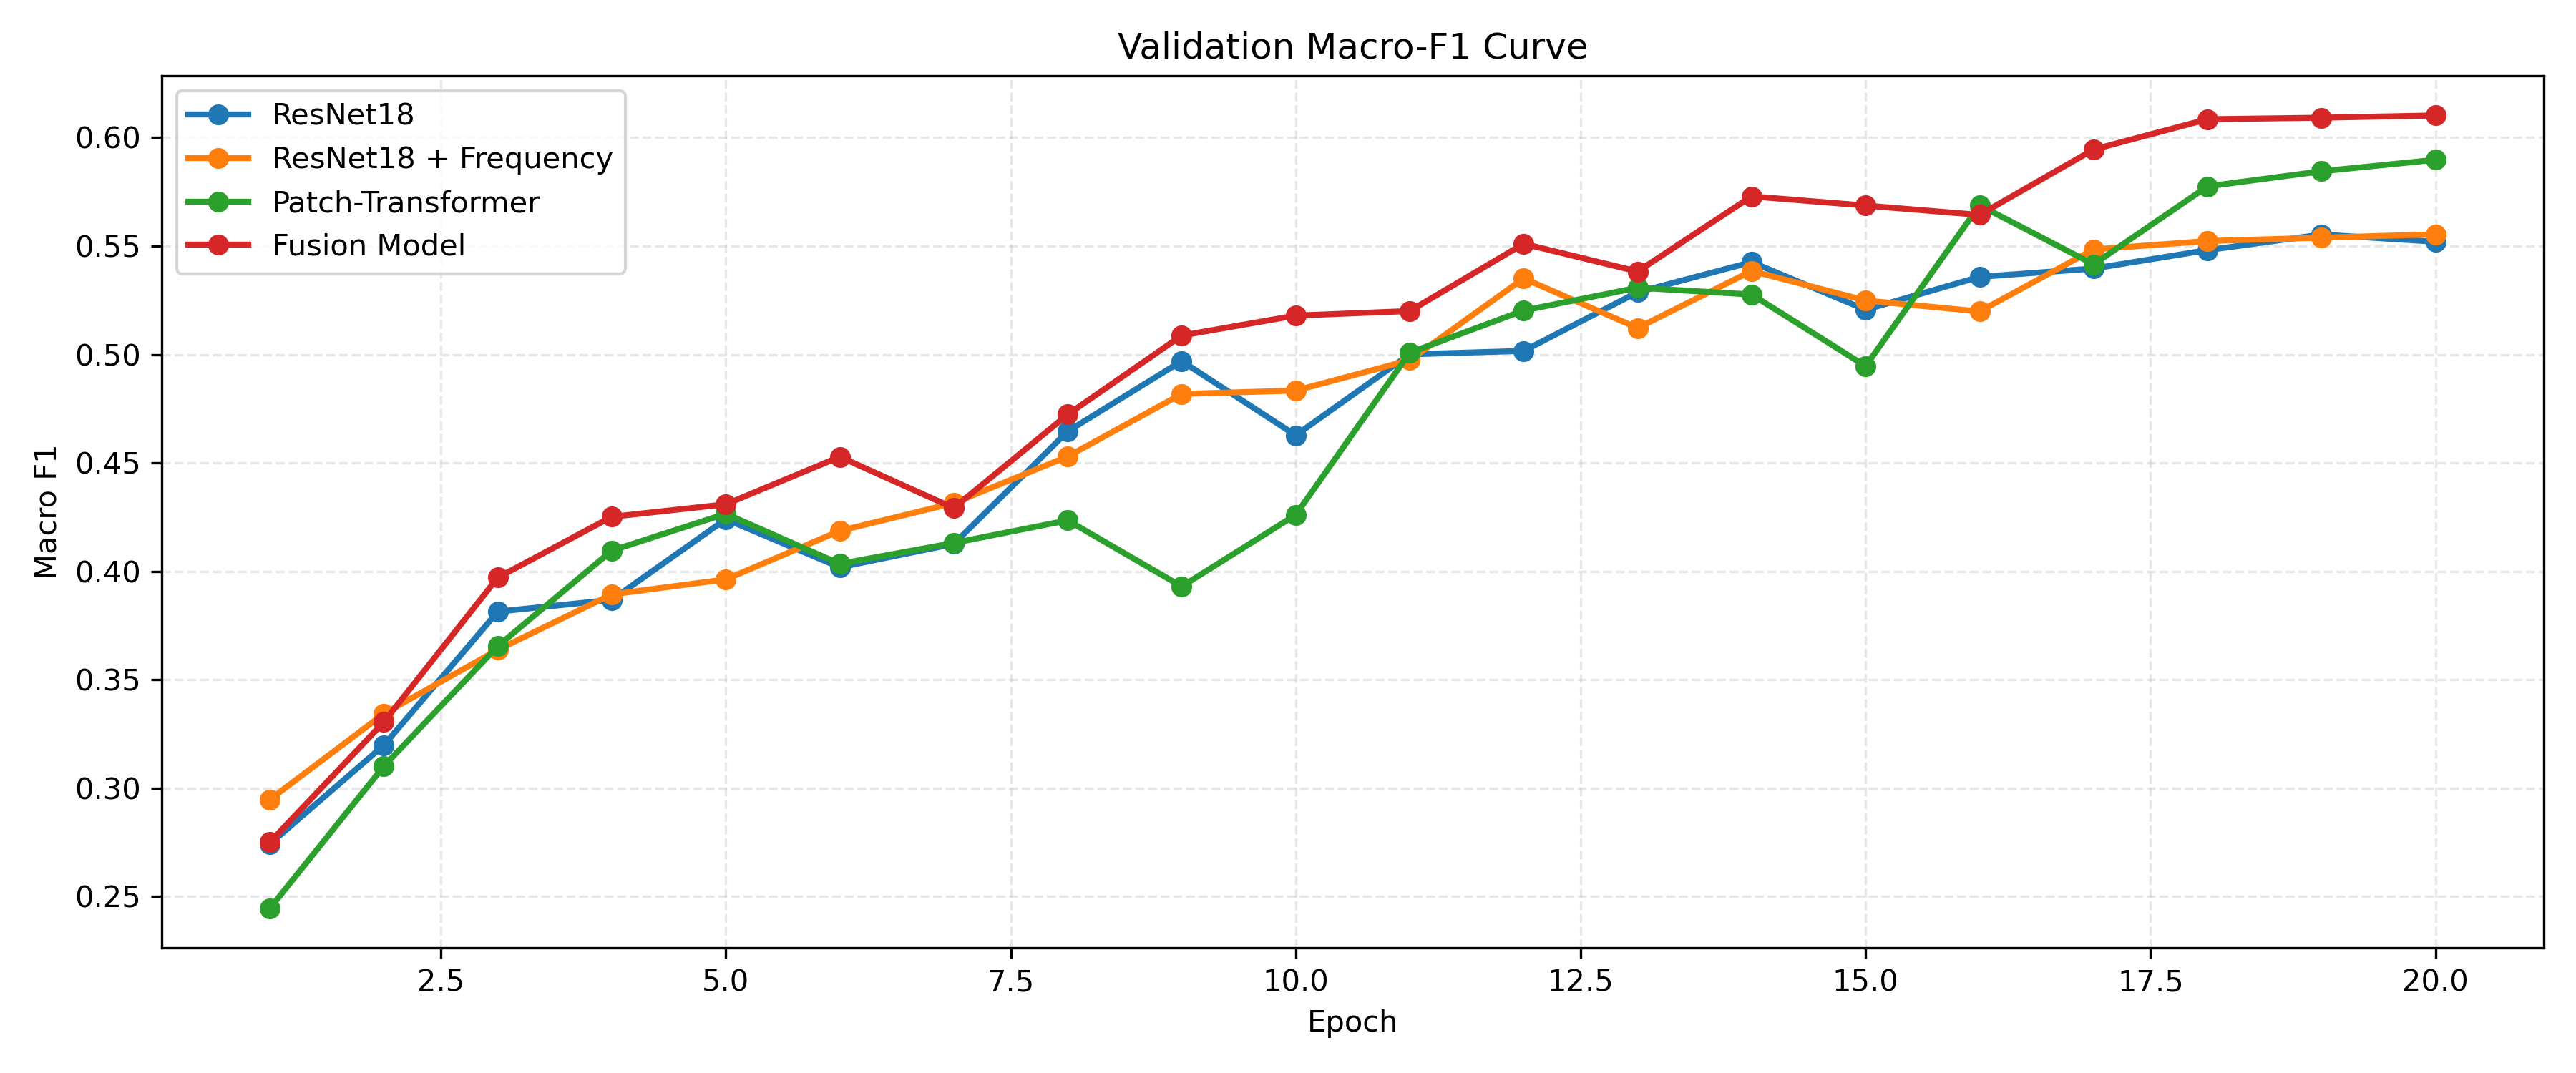
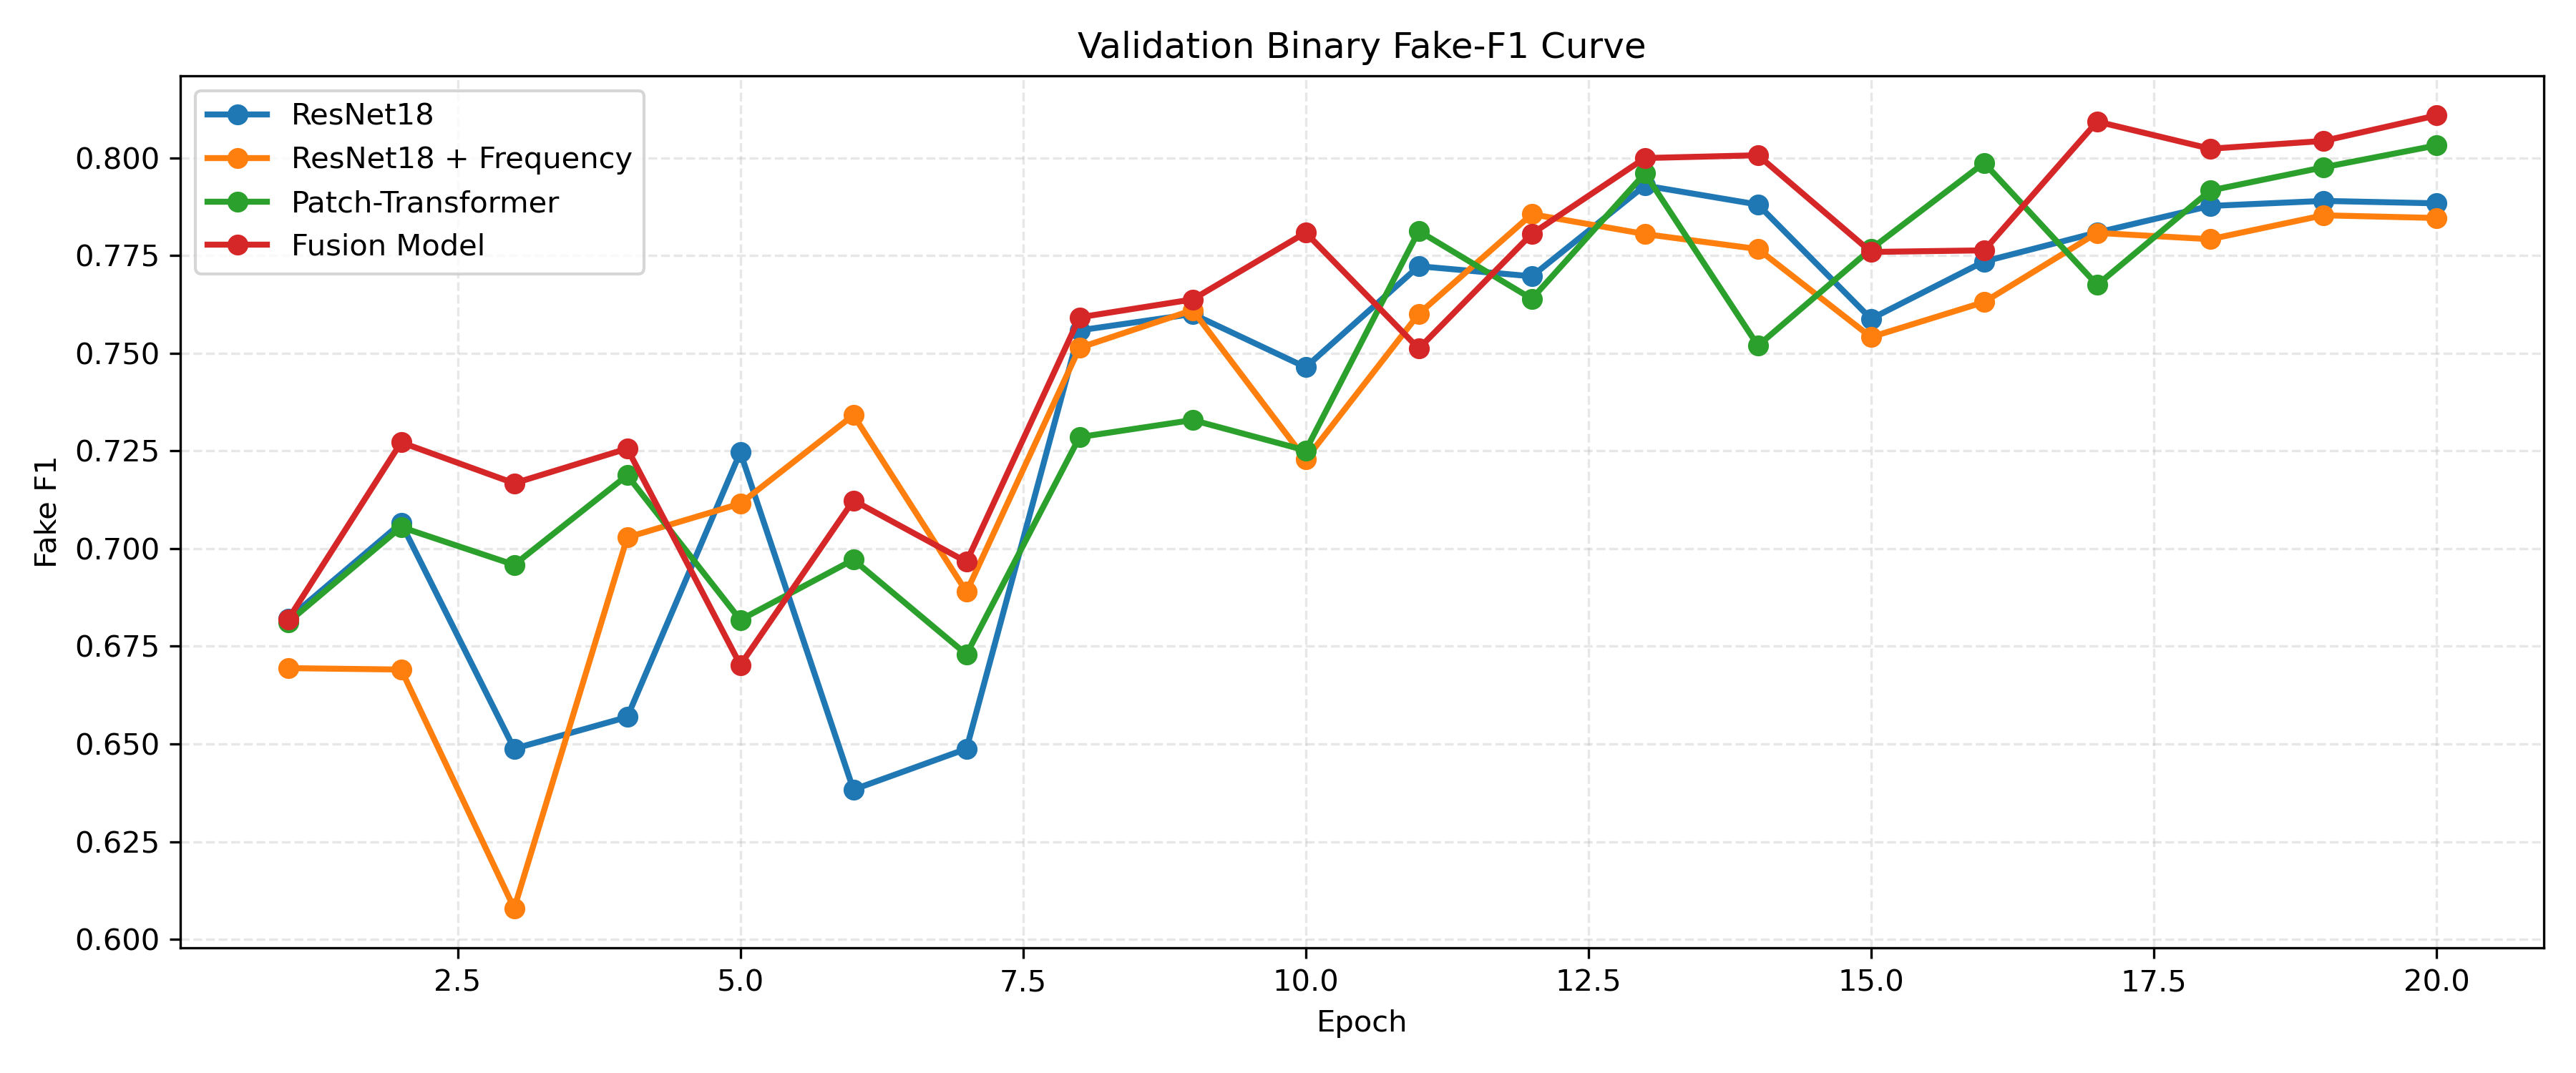
频域分支接在全局 ResNet 向量后几乎零收益(55.53% → 55.54%)。保留局部 patch 结构后才有实质提升 (→ 58.98%),说明局部结构与频域线索需要一起看才有效。
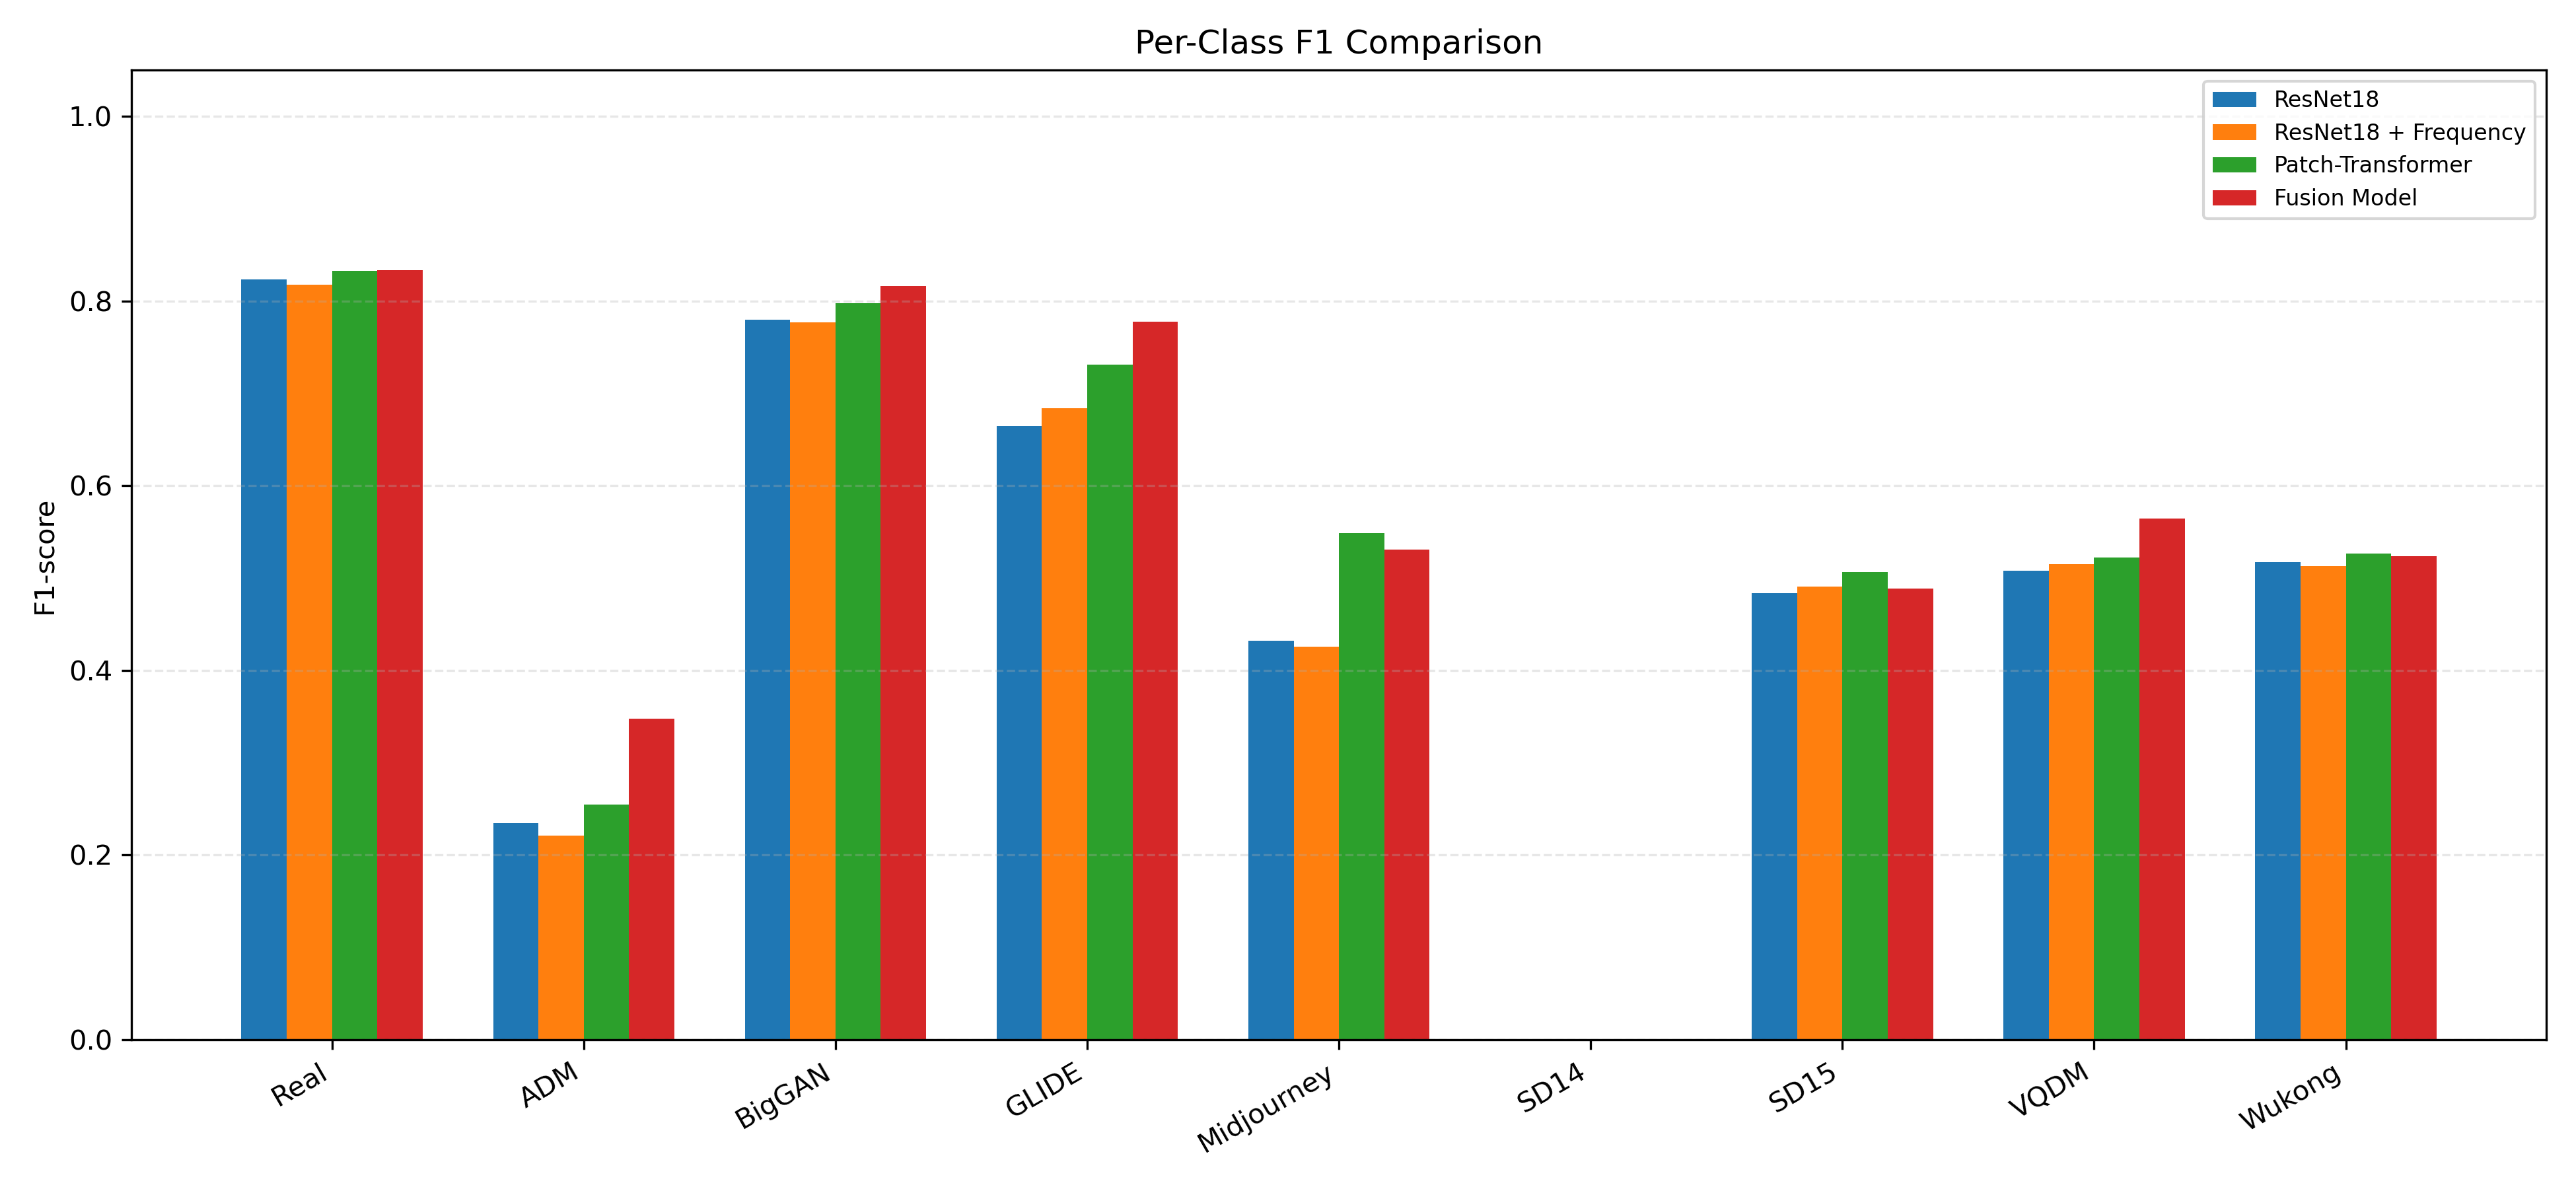
Real、BigGAN、GLIDE 识别较好;ADM、SD14、Midjourney、Wukong 是主要失分项。
SD14 在所有模型中 F1 为 0——该类在验证集中几乎无法被召回。
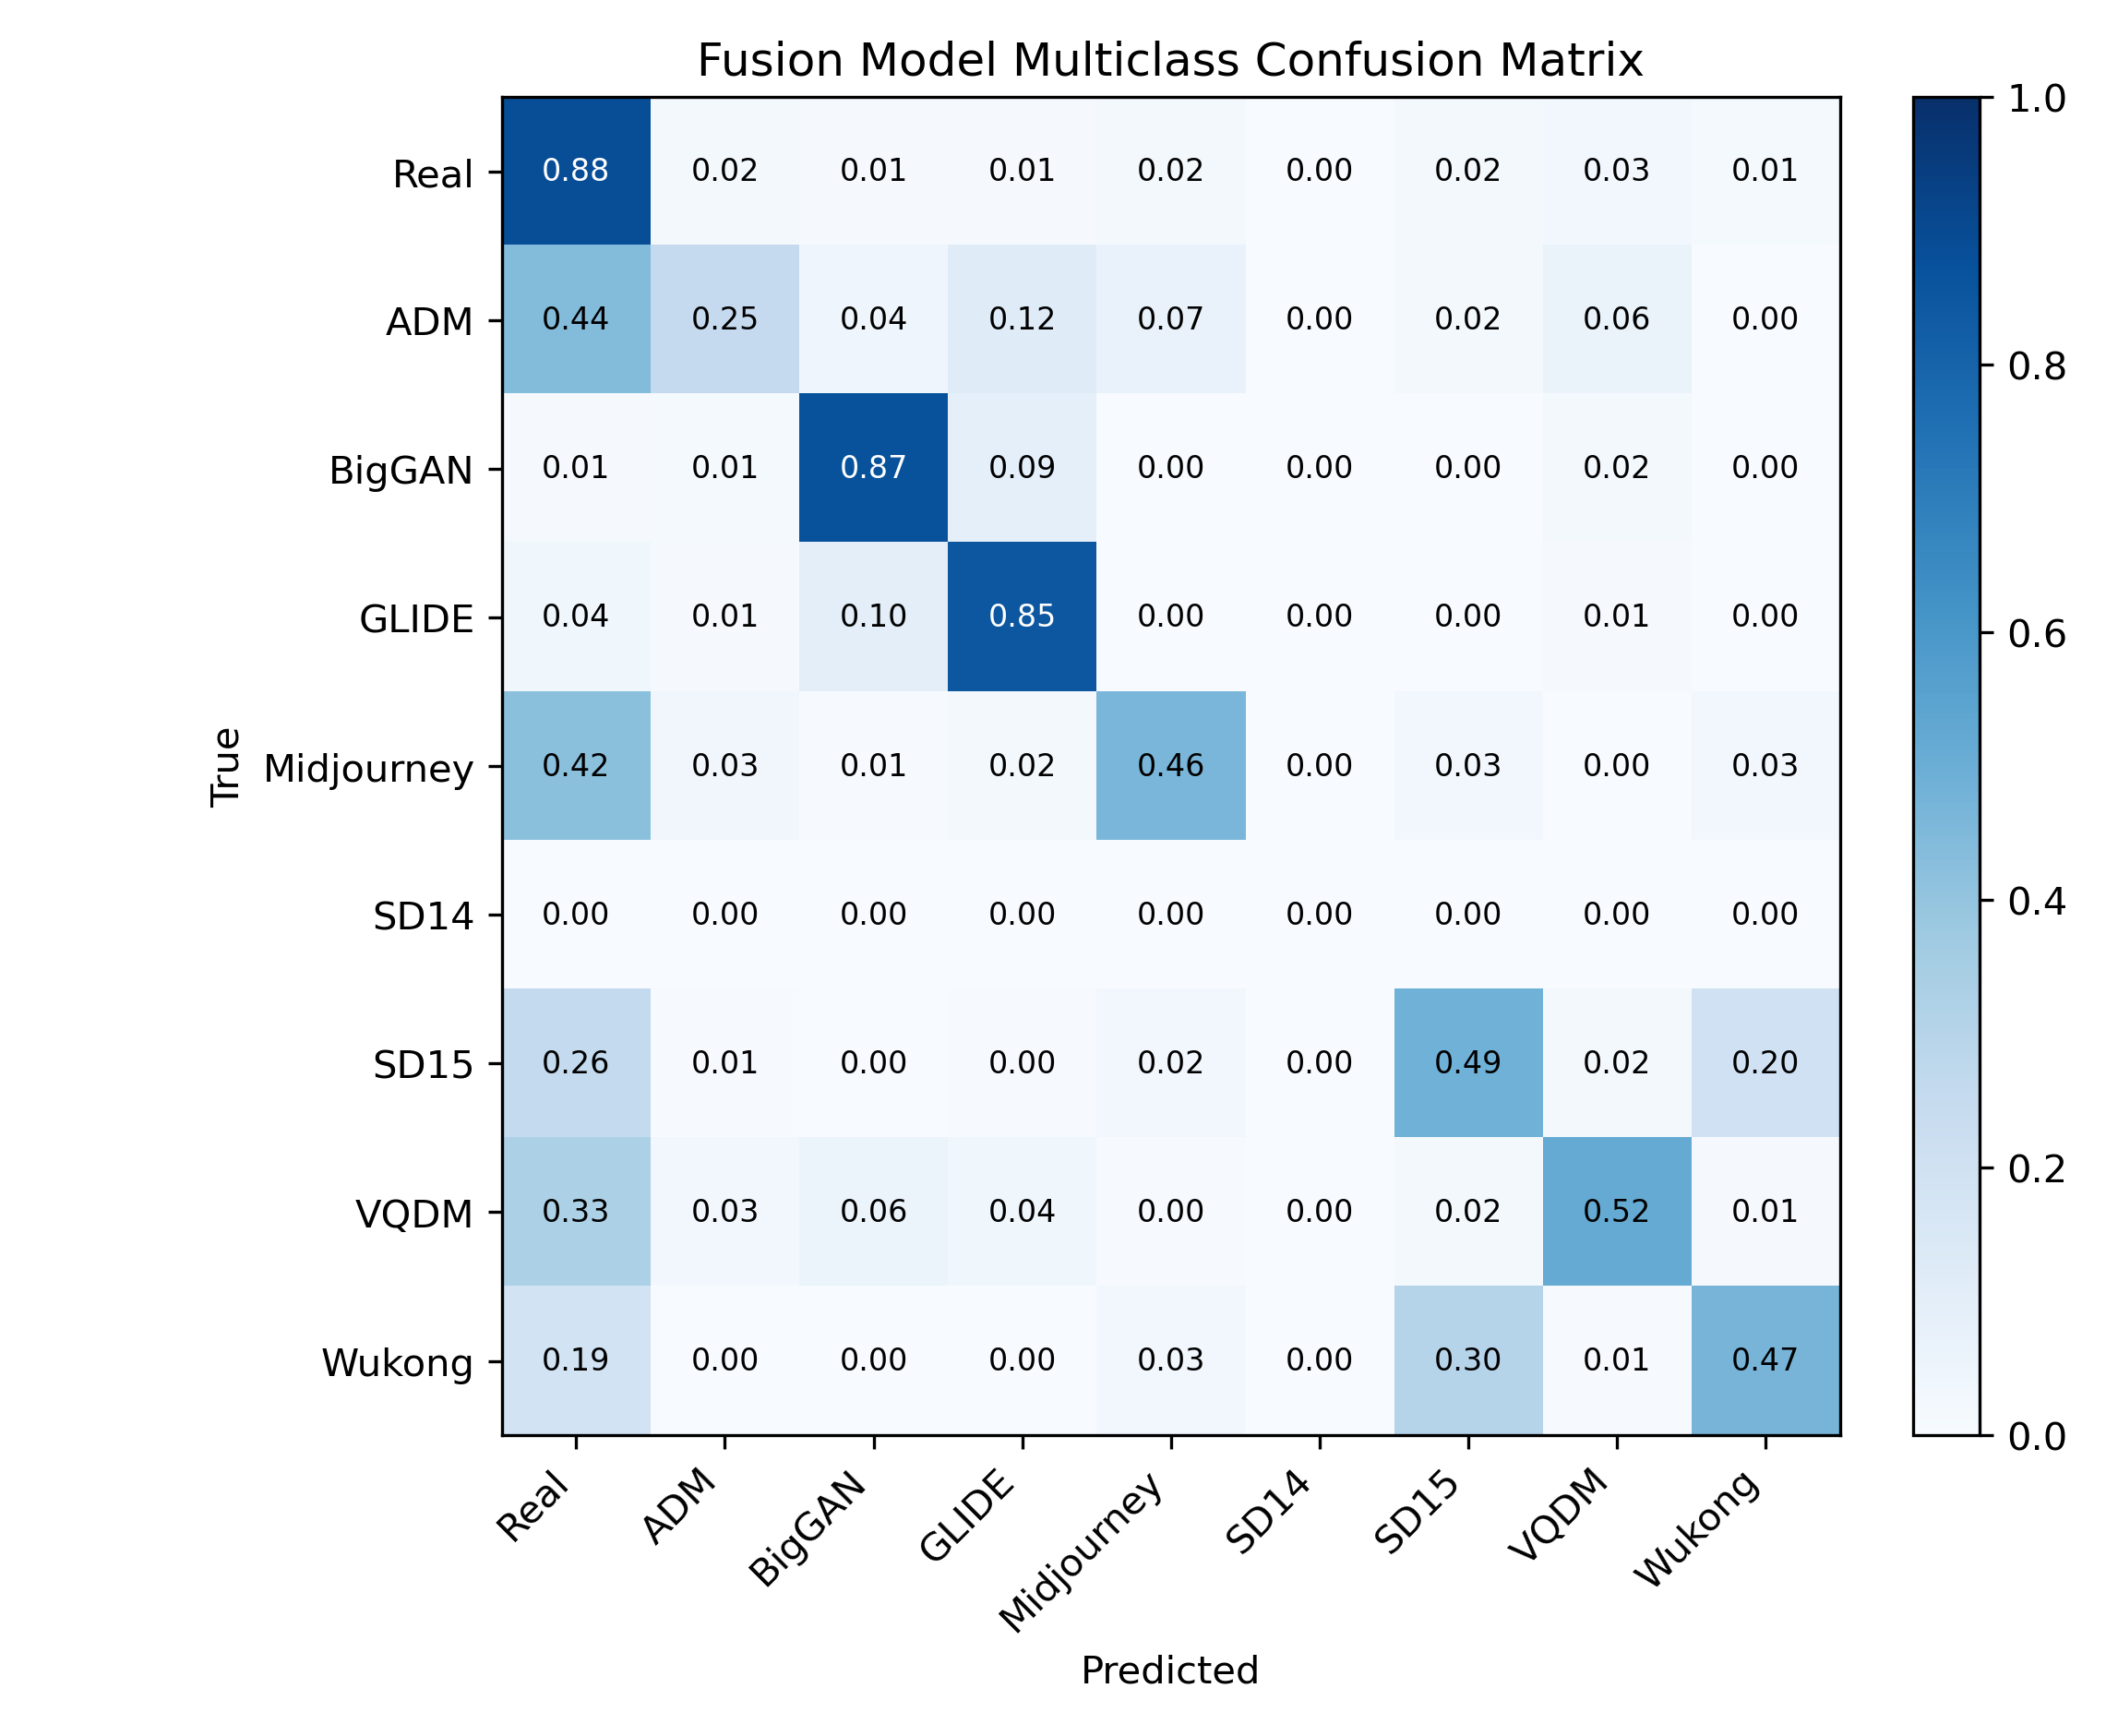
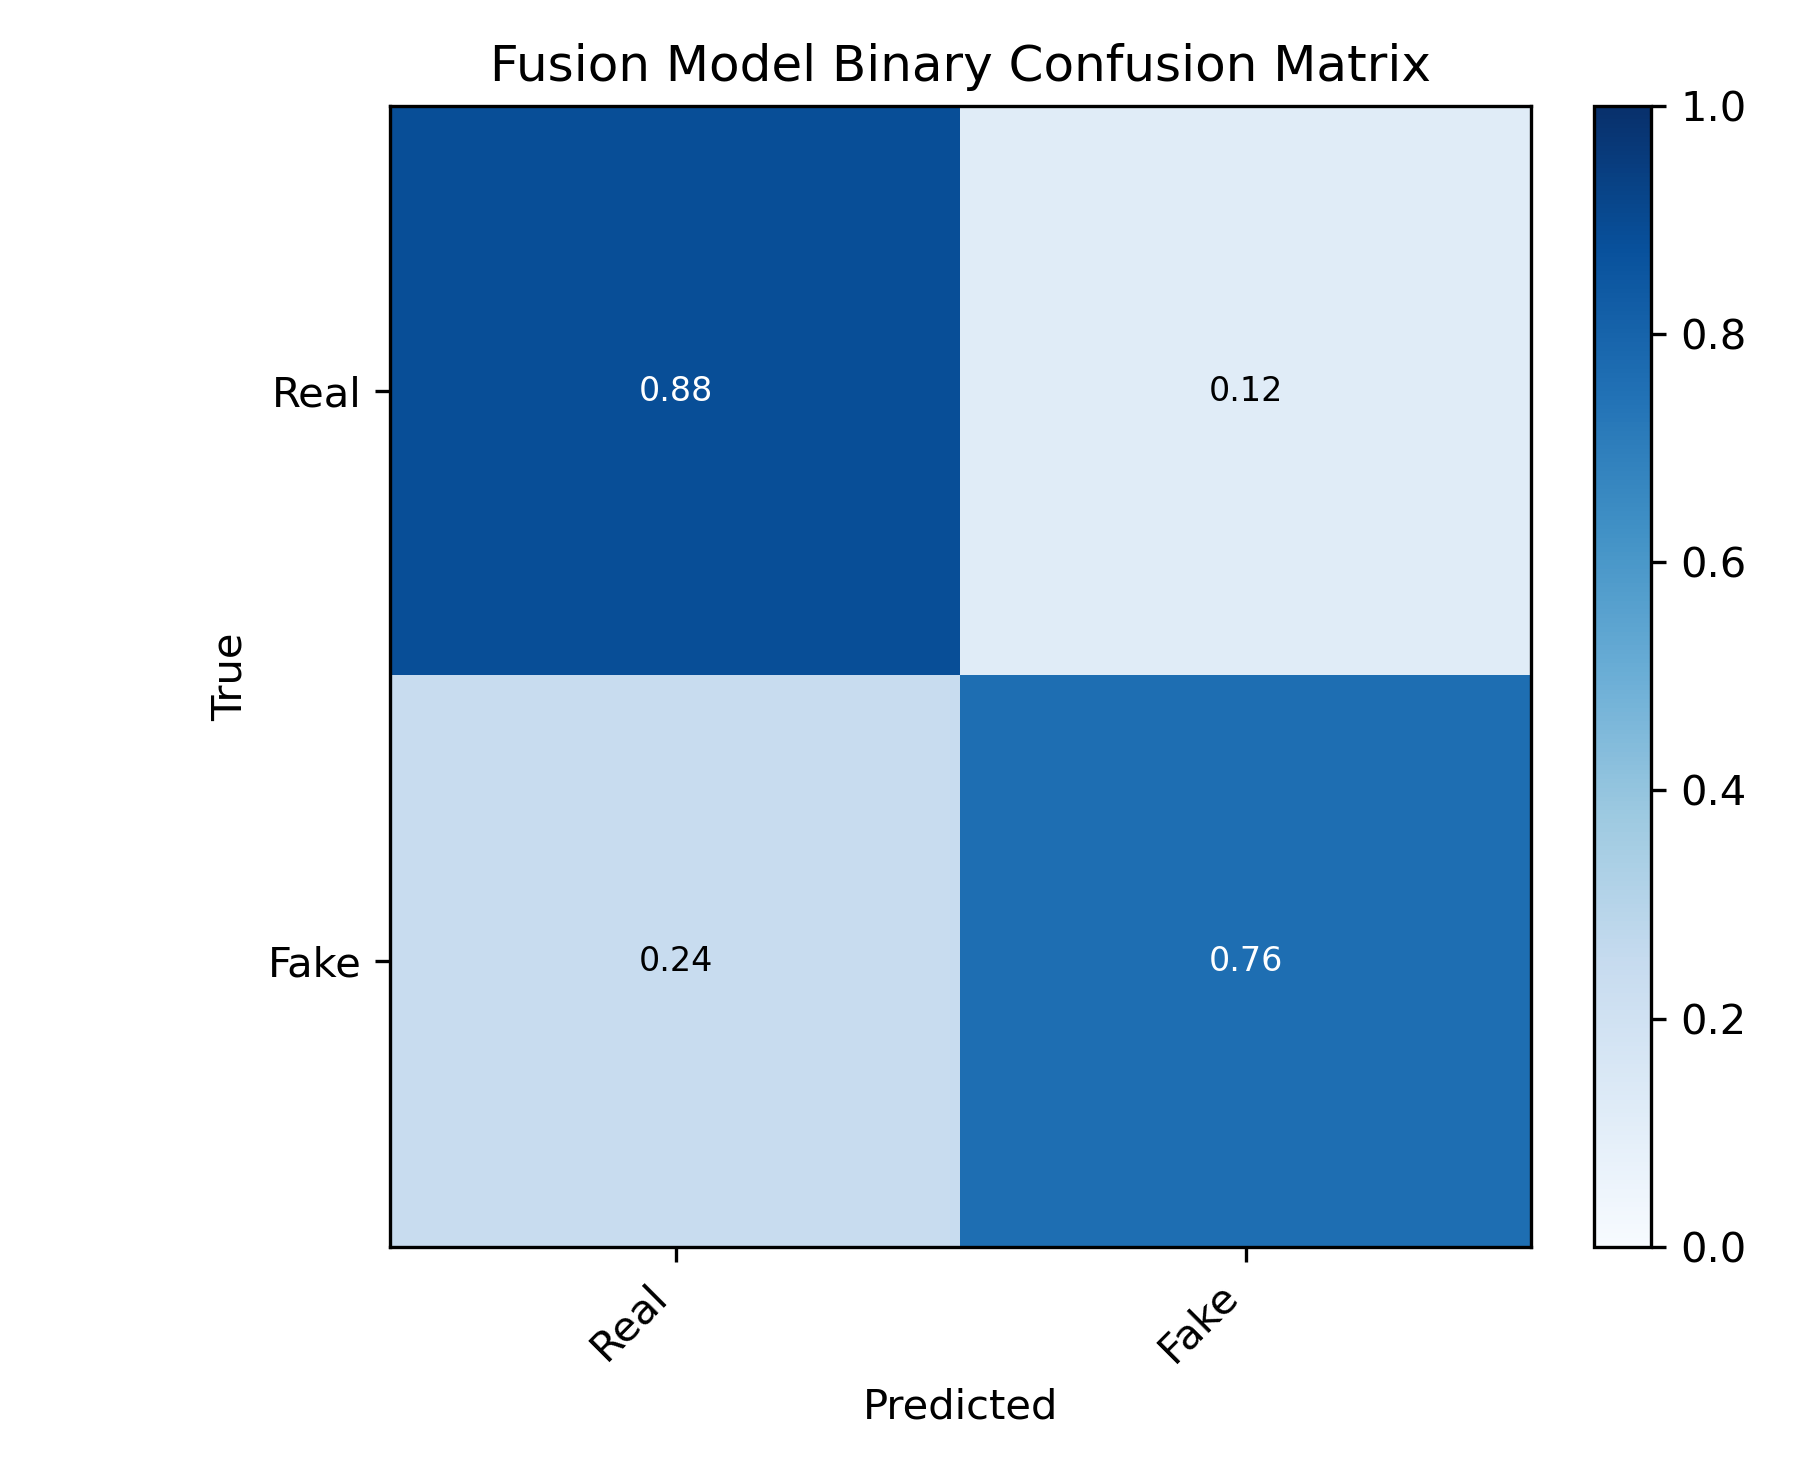
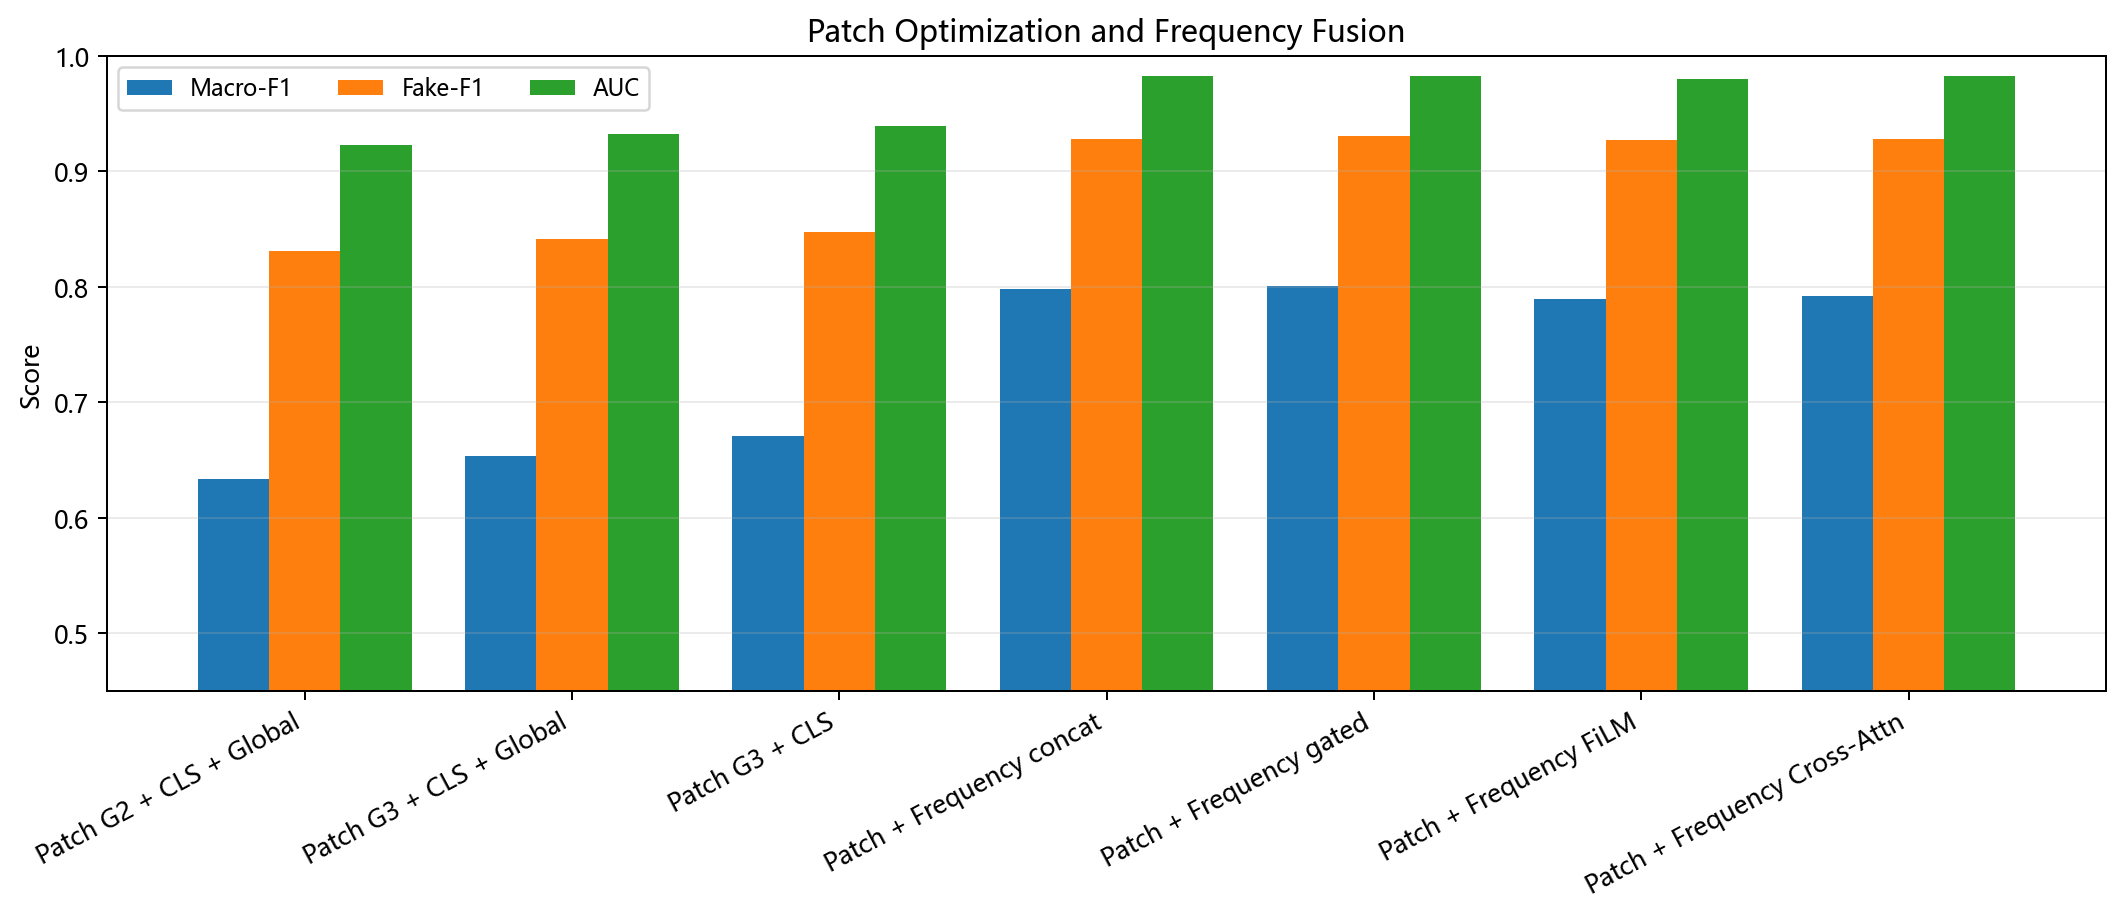
| Patch 设置 | 多分类 Acc | Macro-F1 | Fake-F1 | AUC |
|---|---|---|---|---|
| g2 + CLS + Global | 73.16% | 63.36% | 83.12% | 92.27% |
| g3 + CLS + Global | 74.80% | 65.38% | 84.12% | 93.22% |
| g3 + CLS(无 global) | 76.21% | 67.11% | 84.80% | 93.90% |
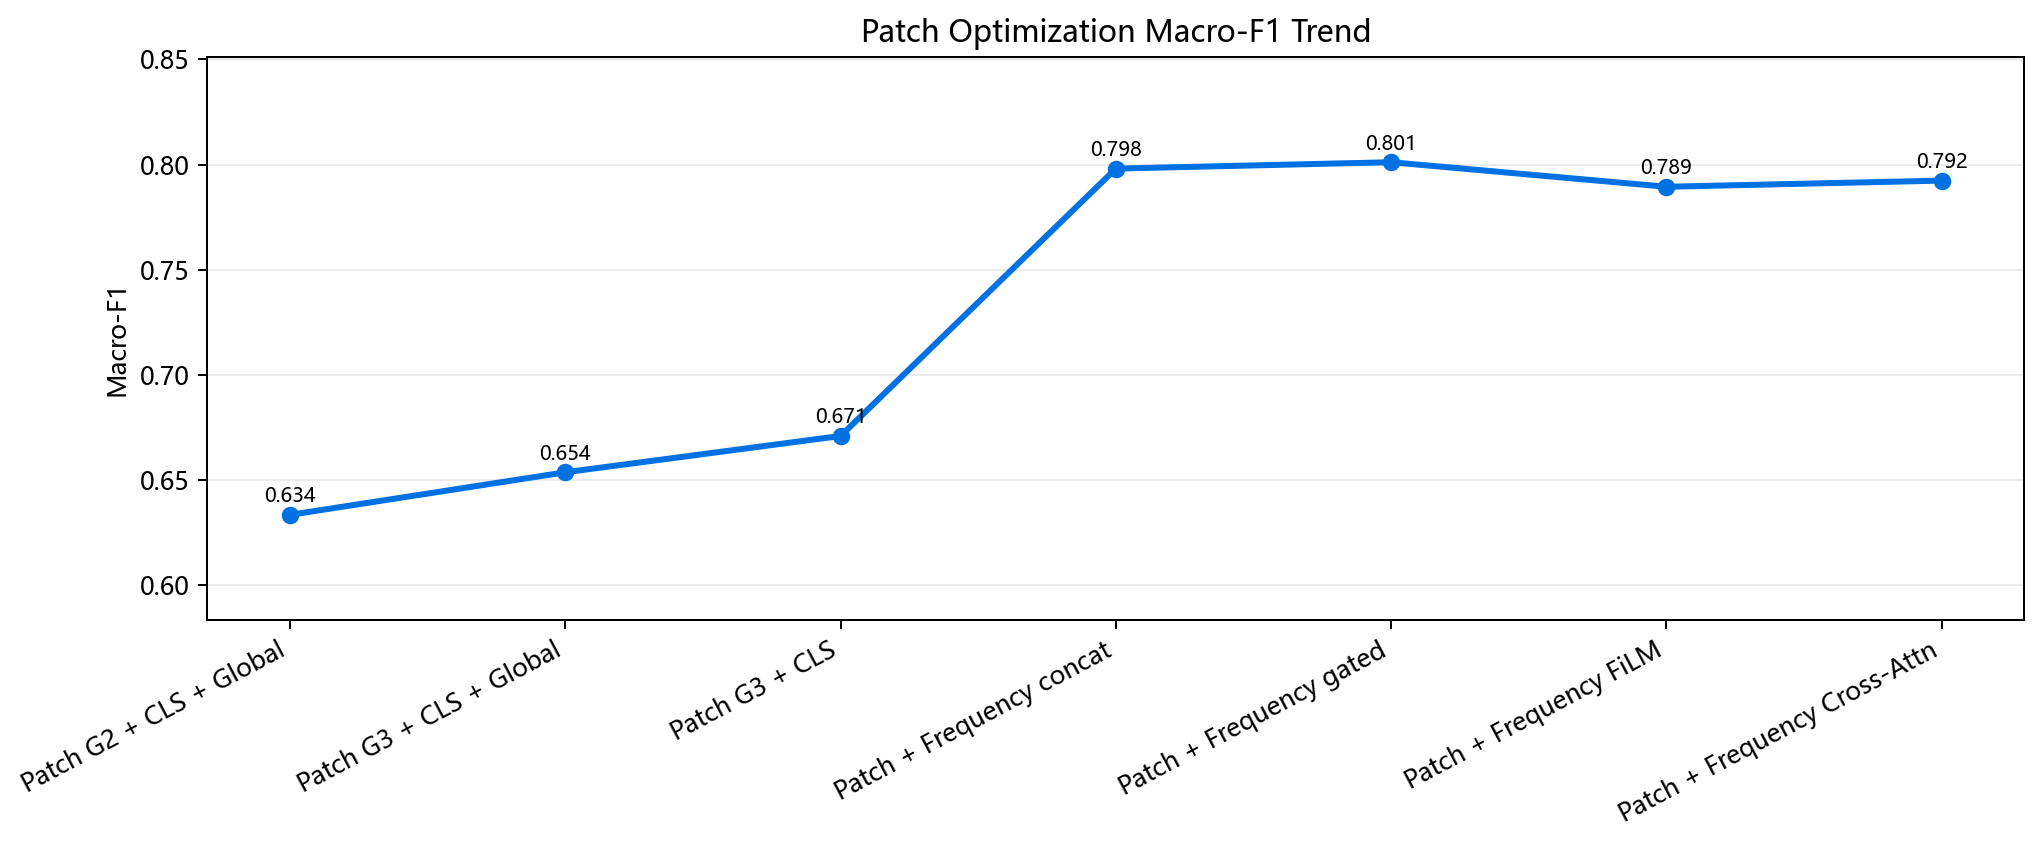
3×3 提供更细的空间划分;去掉 global token 反而更好——global token 会把局部伪影重新压缩成全局平均特征, 削弱局部生成痕迹的辨识度。
| 融合机制 | 多分类 Acc | Macro-F1 | Fake-F1 | AUC |
|---|---|---|---|---|
| concat | 85.69% | 79.81% | 92.83% | 98.25% |
| gated | 85.99% | 80.11% | 93.06% | 98.25% |
| FiLM | 85.10% | 78.95% | 92.72% | 98.03% |
| cross-attn | 85.39% | 79.24% | 92.80% | 98.24% |
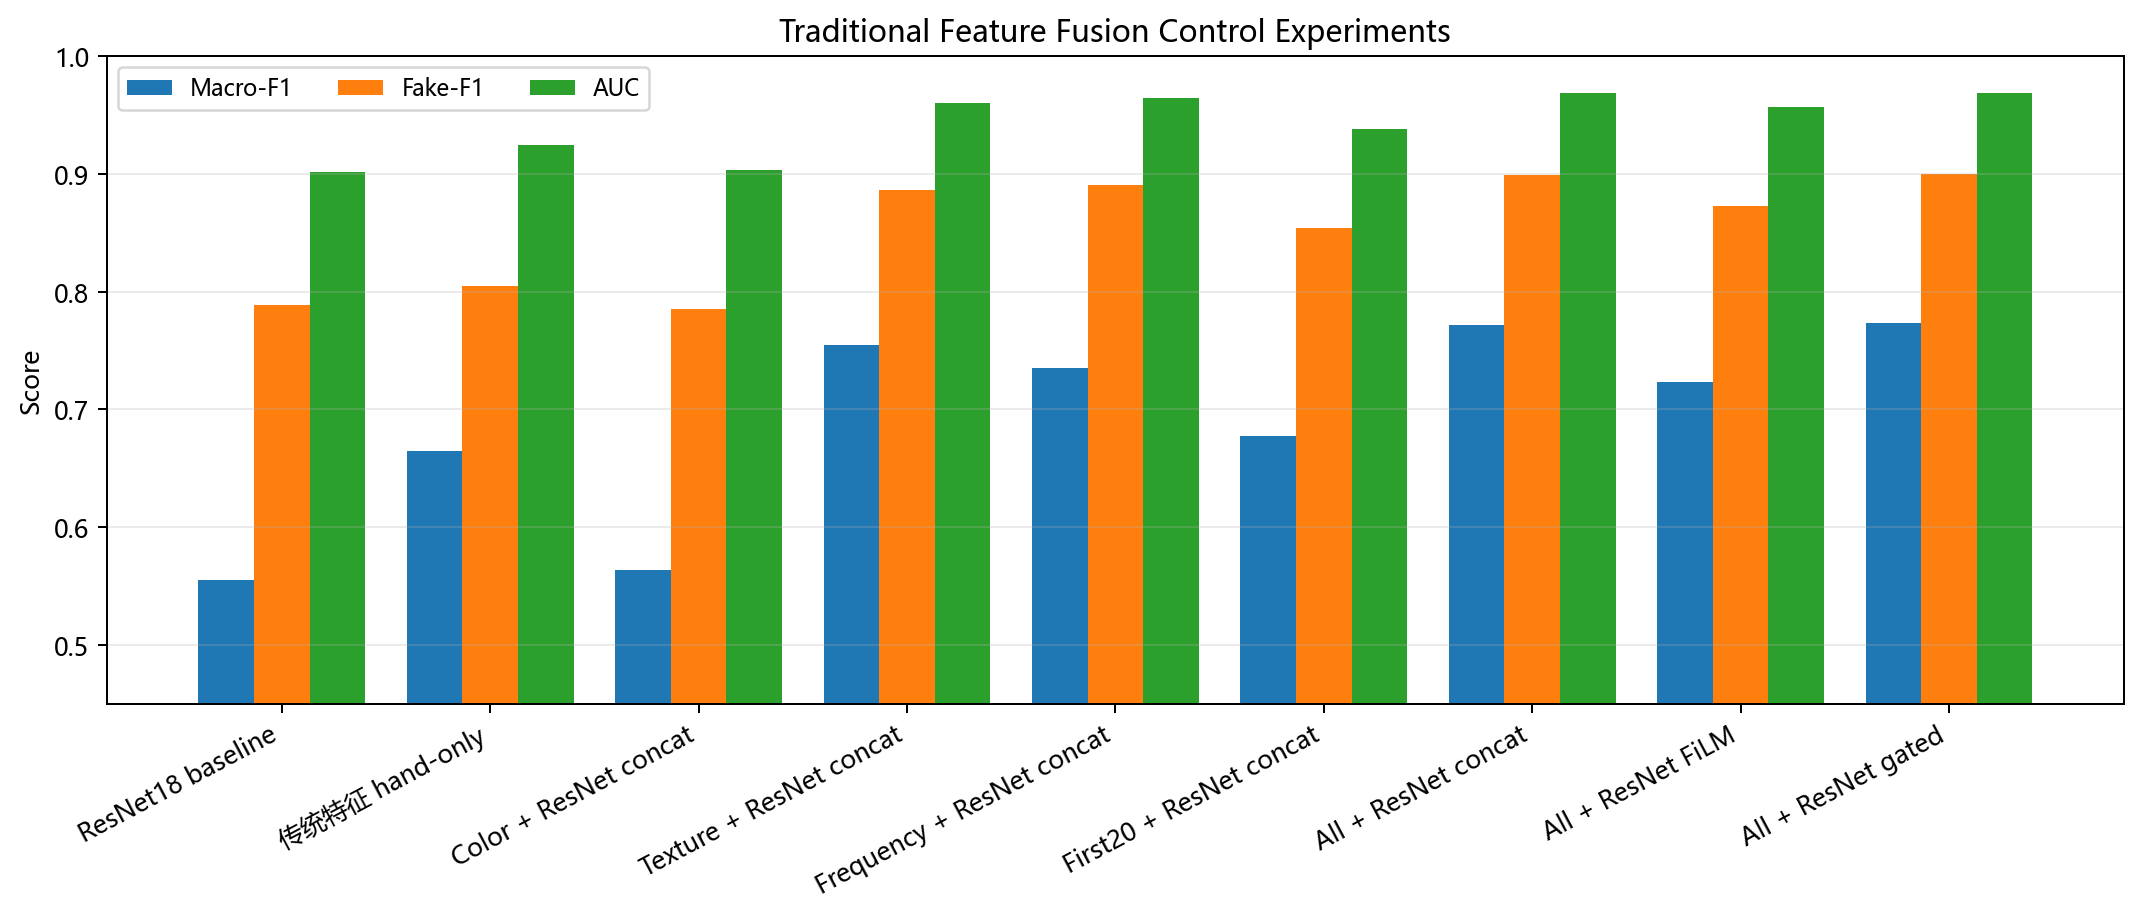
| 实验 | 多分类 Acc | Macro-F1 | Fake-F1 | AUC |
|---|---|---|---|---|
| ResNet18 baseline | 69.53% | 55.53% | 78.90% | 90.17% |
| hand-only(仅传统特征) | 75.79% | 66.47% | 80.51% | 92.44% |
| color + concat | 69.79% | 56.38% | 78.48% | 90.32% |
| first20 + concat | 77.09% | 67.74% | 85.41% | 93.79% |
| texture + concat | 82.01% | 75.50% | 88.61% | 96.00% |
| frequency + concat | 81.24% | 73.50% | 89.01% | 96.46% |
| all + concat | 83.41% | 77.17% | 89.89% | 96.87% |
| all + gated | 83.61% | 77.37% | 90.02% | 96.89% |
| all + FiLM | 80.11% | 72.31% | 87.26% | 95.64% |
关键发现:
color几乎无收益(56.38%),颜色统计量对生成器溯源无用hand-only达到 66.47%,说明手工特征单独就有相当强的类信号texture与frequency是收益主力- 但全局统计的共性是空间结构缺失——局部伪影被压成全局摘要
改用网格化统计:按 4×4 网格分别计算 LBP、HOG 和 FFT 高频残差,使传统特征保留粗粒度空间位置。
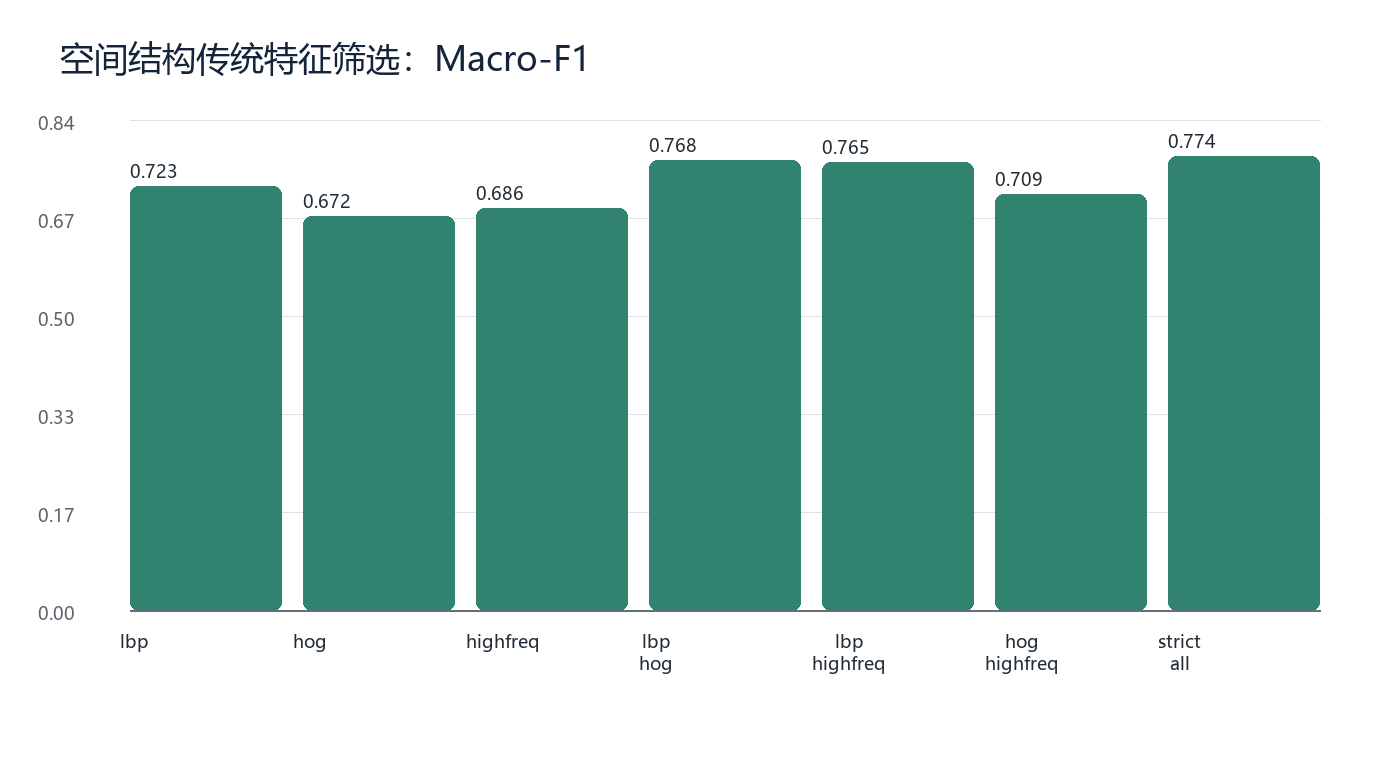
| 特征组 | 多分类 Acc | Macro-F1 | Fake-F1 | AUC |
|---|---|---|---|---|
| LBP | 79.94% | 72.27% | 88.35% | 95.89% |
| HOG | 76.29% | 67.24% | 83.49% | 92.76% |
| 高频残差 | 77.49% | 68.56% | 85.75% | 94.33% |
| LBP + HOG | 82.51% | 76.84% | 88.61% | 96.09% |
| LBP + 高频 | 82.79% | 76.51% | 89.26% | 96.45% |
| HOG + 高频 | 78.60% | 70.94% | 86.04% | 94.53% |
| strict_all(三者) | 83.40% | 77.42% | 89.49% | 96.58% |
三者互补:LBP 抓局部纹理二值模式,HOG 抓方向梯度结构,高频残差抓锐化/纹理抖动/边缘异常。
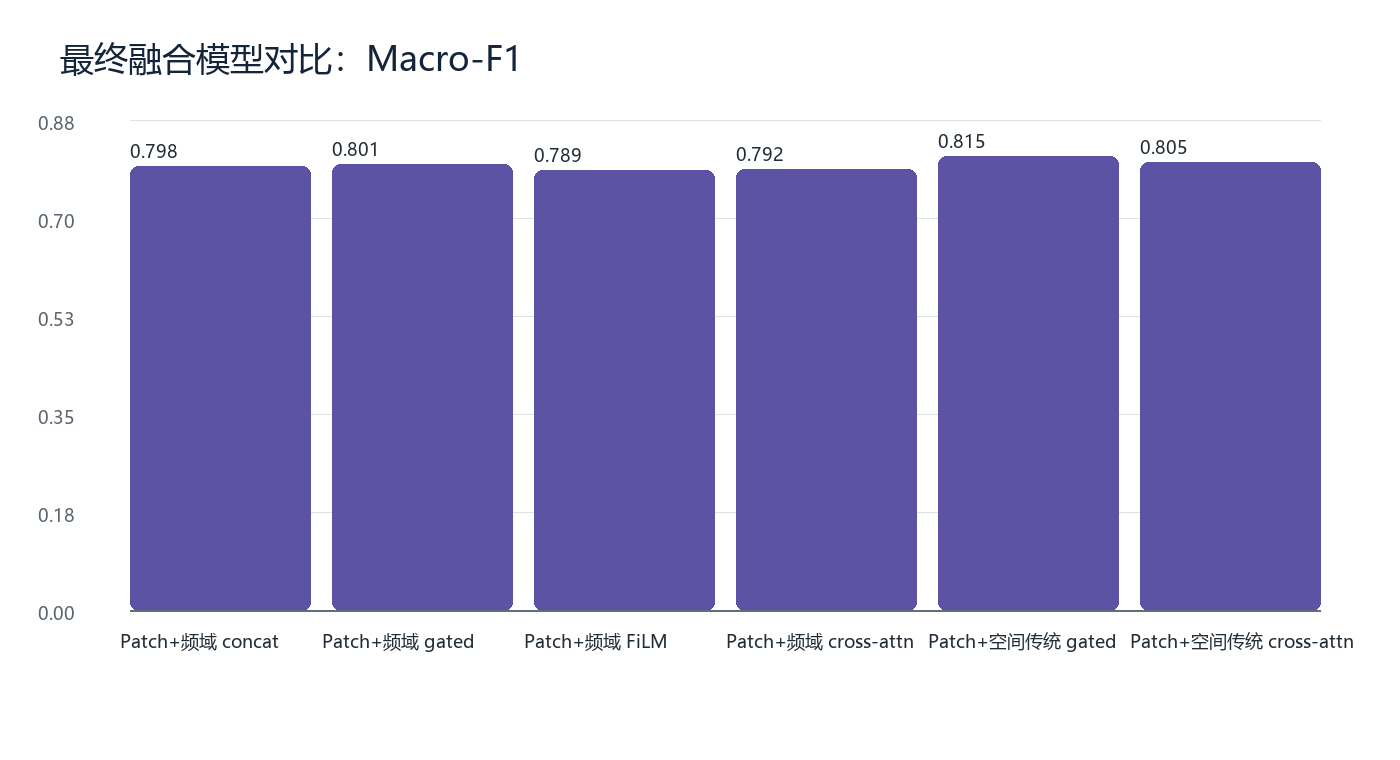
| 模型 | 多分类 Acc | Macro-F1 | Fake-F1 | AUC |
|---|---|---|---|---|
| Patch + 频域 concat | 85.69% | 79.81% | 92.83% | 98.25% |
| Patch + 频域 gated | 85.99% | 80.11% | 93.06% | 98.25% |
| Patch + 频域 FiLM | 85.07% | 78.95% | 92.55% | 98.12% |
| Patch + 频域 cross-attn | 85.39% | 79.24% | 92.80% | 98.24% |
| Patch + 空间传统 gated | 86.27% | 81.49% | 91.88% | 97.88% |
| Patch + 空间传统 cross-attn | 85.76% | 80.51% | 91.61% | 97.67% |
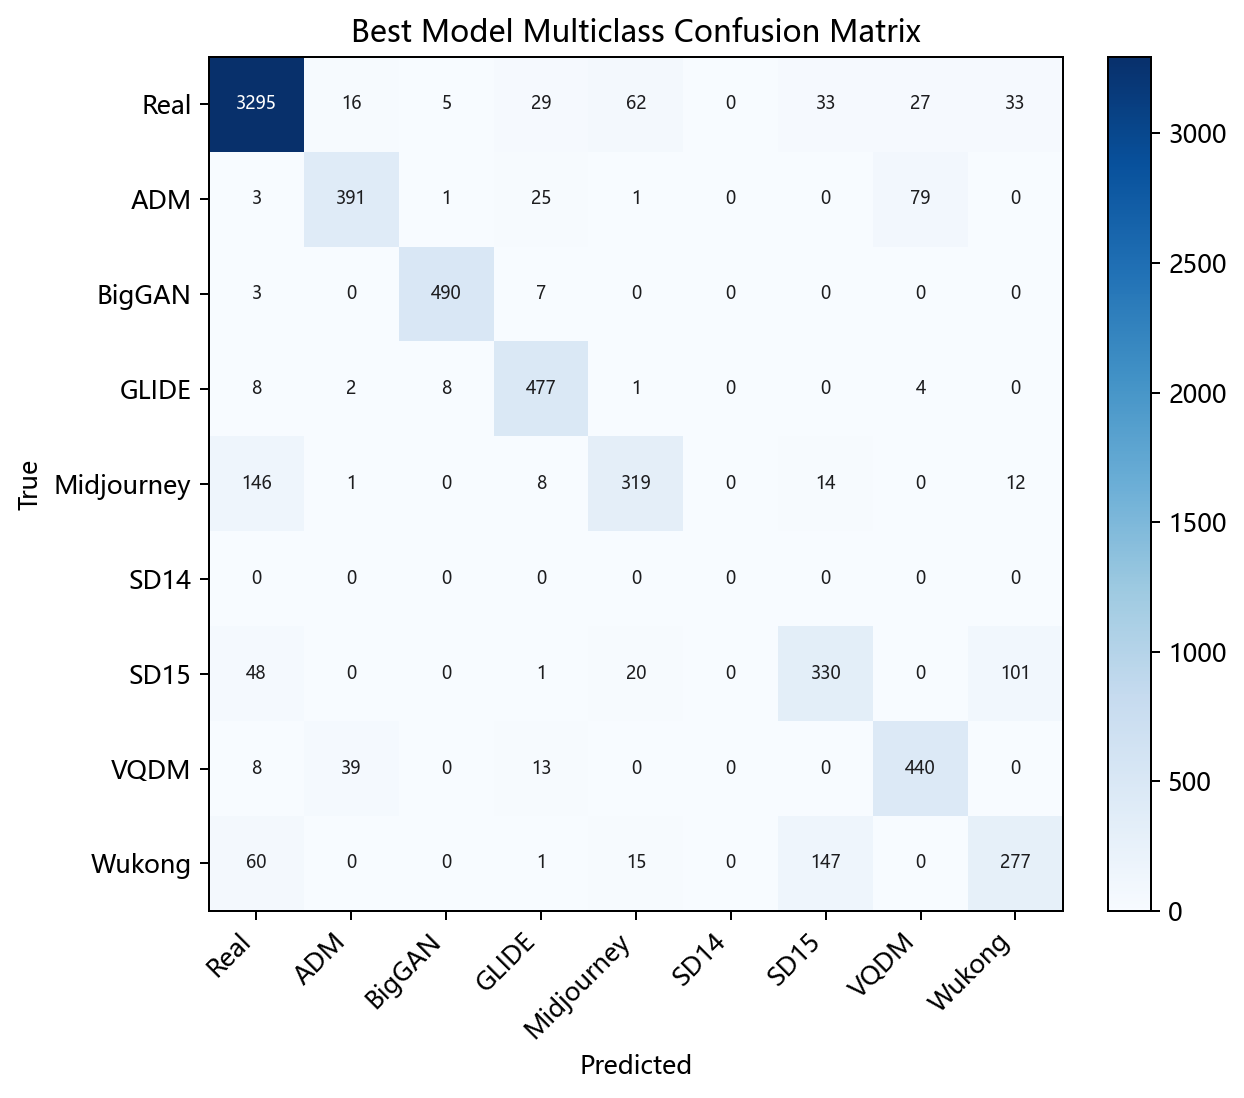
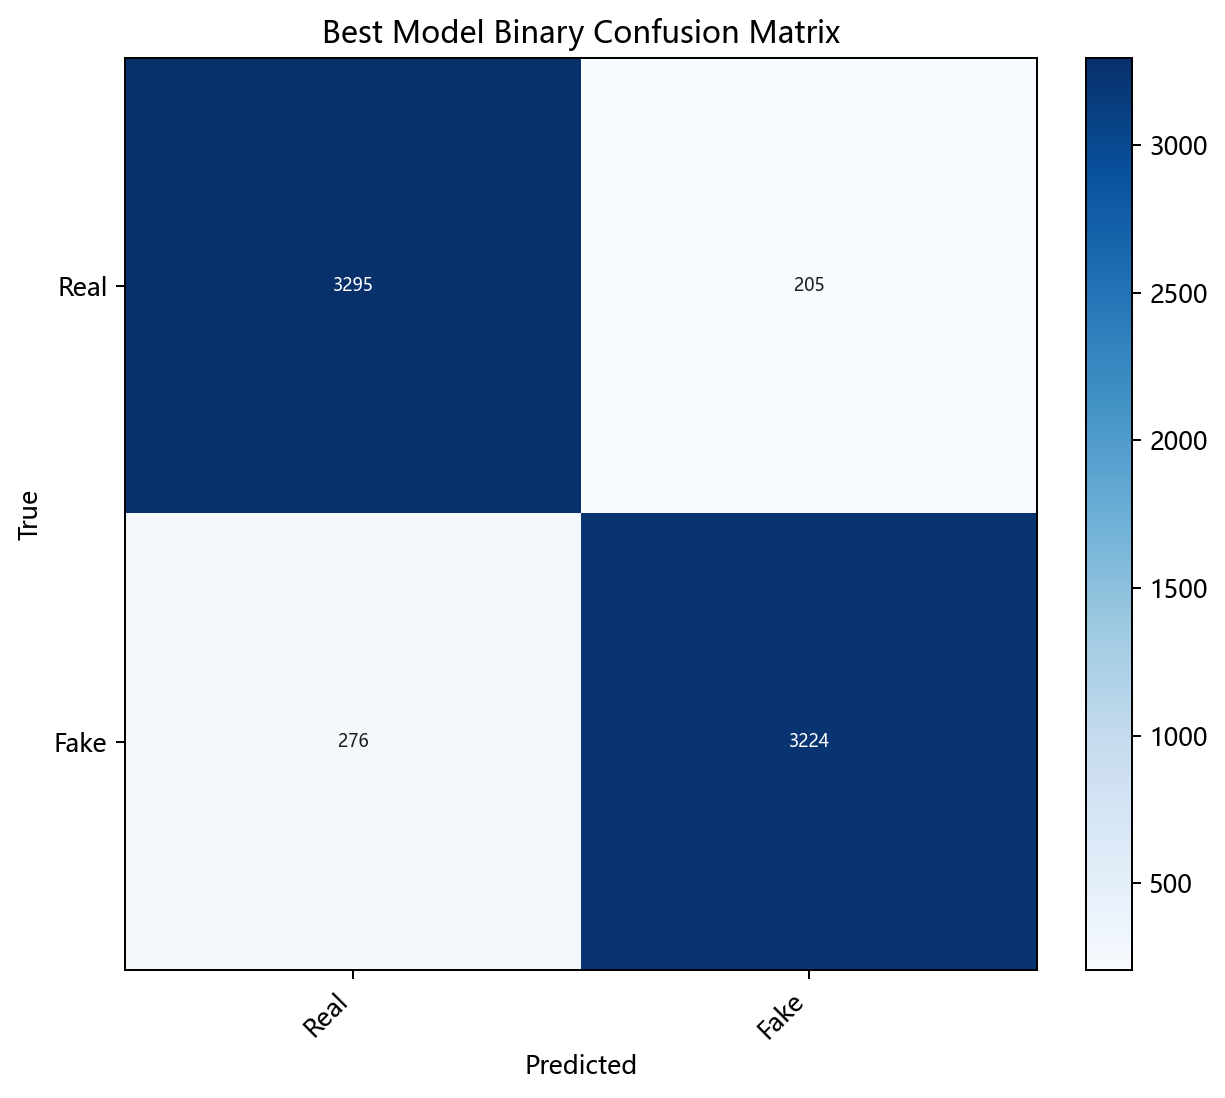
gated 优于 cross-attention 的原因:当前传统特征是紧凑向量而非长序列 token。 门控直接学习"当前样本更信深度特征还是传统特征",具备动态选择与噪声抑制作用; cross-attention 在只有单个传统 token 时注意力空间有限,表达优势无法发挥。
ResNet18 的全局平均池化把空间结构压成单个 512 维向量。频域向量 concat 到末端时更像冗余信号,容易被当作噪声处理。 Patch-Transformer 先保留局部区域 token,再由 Transformer 建模区域关系,频域特征才能与局部伪影形成互补。
频域不是无效特征,但它不是任何结构下都有效。它能否发挥作用,取决于是否与模型保留的空间/局部线索对齐, 以及融合机制能否抑制不可靠频段。
Synthbuster 由不同生成器产生,后处理、压缩、分辨率、内容分布都与训练数据不同,且不含与训练集一致的真实类对照。 原始模型学到的伪影很可能源于数据源、压缩格式或生成器版本偏差,因此外部分布上 Fake 概率整体偏低。
这也正说明:高同分布性能不等于检测能力。
pip install -r requirements.txtPyTorch 2.x + CUDA。多卡依赖 torch.distributed(NCCL)。
需要 Tiny-GenImage 的 parquet 分片:
data/Tiny-GenImage/
└── data/
    ├── train-*.parquet
    └── validation-*.parquet
每个 parquet 需含 image(带 bytes 字段)和 generator(整数标签)两列。
首次运行会把 parquet 解包为 jpg 写入 cache/,后续复用。
python train_resnet18_baseline.pypython -m torch.distributed.run --nproc_per_node=8 train_resnet18_baseline.py| 参数 | 默认值 |
|---|---|
--data-root |
./data/Tiny-GenImage |
--cache-root |
./cache/Tiny-GenImage |
--output-root |
./outputs |
# 主实验:Patch 优化 + 频域融合
python -m torch.distributed.run --nproc_per_node=8 train_patch_transformer_optimized.py \
  --mode patch --patch-grid 3 --use-cls --no-global --epochs 20

# 传统特征融合(gated)
python -m torch.distributed.run --nproc_per_node=8 train_resnet18_traditional_fusion.py \
  --feature-set all --fusion gated --epochs 20

# 传统特征缓存预计算(DDP 前必须单独执行)
python train_resnet18_traditional_fusion.py --feature-set all --prepare-onlybash run_all_experiments.sh # 基础三模型对比
bash run_fusion_experiment.sh # 三路融合
bash run_traditional_feature_experiments.sh # 手工特征筛选 + 融合方式对比
bash run_patch_optimization_experiments.sh # 切块模块消融脚本默认调用 python,可通过环境变量指定:
PYTHON=/path/to/python bash run_all_experiments.sh注意:
run_traditional_feature_experiments.sh会先用--prepare-only单进程预计算手工特征缓存。 手工特征提取是 CPU 密集型操作,若在 DDP worker 内进行容易触发 NCCL 超时,不要跳过这一步。
outputs/<experiment_name>/
├── config.json
├── history.json
├── best_model.pth
└── best_eval/
    ├── metrics.json
    ├── classification_report.json
    ├── confusion_matrix_multiclass.csv
    ├── confusion_matrix_binary.csv
    └── predictions.csv
python compare_all_models.py             # 四模型指标汇总
python visualize_results.py              # 柱图、训练曲线、混淆矩阵、每类 F1
python compare_traditional_fusion.py     # 手工特征实验对比
python compare_patch_optimization.py     # 切块/频域融合对比
图片输出到 outputs/figures/ 及各自的 *_analysis/ 目录。
| 文件 | 作用 |
|---|---|
common.py |
数据缓存、manifest、DDP 初始化、指标计算、混淆矩阵保存 |
train_resnet18_baseline.py |
ResNet18 基线 |
train_resnet18_frequency.py |
频域分支实验 |
train_patch_transformer_optimized.py |
Patch-Transformer 及融合实验 |
train_resnet18_traditional_fusion.py |
传统特征提取、缓存、融合训练 |
train_fusion_model.py |
三路融合模型 |
compare_*.py / visualize_results.py |
结果汇总与绘图 |
- 所有骨干网络均为
weights=None,从零训练。使用 ImageNet 预训练通常能显著提升精度,本项目未做该对照。 - 空间结构传统特征(LBP/HOG/高频残差网格统计)的代码未包含在仓库中,第 5.6、5.7 节的结果由实验记录整理而来,仅图表可复现,训练脚本需另行补充。
patch_transformer中每个 patch 会被F.interpolate放大回原分辨率,g 较大时插值会模糊掉原始高频细节。- DDP 模式下
common.evaluate的val_loss只反映当前 rank 的局部均值,仅作日志参考;模型选择依据是 macro-F1。 SD14类在验证集中召回率为 0,该类的归因结论不可靠。- 仅支持 ImageNet 归一化参数。
- 把 LBP/HOG/高频残差拆成网格 token 序列而非单向量,再喂给 cross-attention
- 跨生成器留一验证:训练时移除某一生成器,测试能否识别未见生成器
- 加入压缩、resize、模糊、裁剪等扰动鲁棒性评估
- 引入 ImageNet 预训练骨干作为对照
- Synthbuster 继续作为 OOD 测试集,但不适合作为主训练集(规模小、缺真实类)
@misc{morantkk2026tinygenimage,
  title  = {Tiny-GenImage: AIGC Image Detection and Generator Attribution},
  author = {Morantkk},
  year   = {2026},
  url    = {https://github.com/Morantkk/tiny_genimage_experiments}
}- Wang, S. Y., Wang, O., Zhang, R., Owens, A., & Efros, A. A. CNN-generated images are surprisingly easy to spot... for now. CVPR 2020.
- Yu, N., Davis, L. S., & Fritz, M. Attributing Fake Images to GANs: Learning and Analyzing GAN Fingerprints. ICCV 2019.
- Zhu et al. GenImage: A Million-Scale Benchmark for Detecting AI-Generated Image. NeurIPS Datasets & Benchmarks.
- Durall, R., Keuper, M., & Keuper, J. Watch your up-convolution: CNN based generative deep neural networks are failing to reproduce spectral distributions.
- Dosovitskiy, A. et al. An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. ICLR 2021.
代码以 MIT License 发布。
数据集许可独立。 Tiny-GenImage、Synthbuster、Original Real/Fake 均由第三方发布,其条款不受本项目覆盖; 数据集中的生成图像还可能受各生成模型自身使用条款约束。使用前请自行确认。本项目不附带任何数据。
数据集来自 Tiny-GenImage。骨干网络来自 torchvision。